
浅谈正则表达式中的分组和引用
- content
{:toc}
由正则表达式如何匹配相同字符出发,讲讲正则表达式中的选择、分组和引用。
问题
在外刊君读者群中看到有人提出这样的一个需求:
把字符串切成连续相同字符的正则怎么写?比如
abbcccdddd切成a,bb,ccc,dddd
之前我对正则表达式也是略有研究,想尝试一下。其实我对正则表达式的学习基本完全来源于犀牛书的第10章,真正看懂这一章,我觉得操作正则表达式应该不在话下。
我的答案
先给出我的答案吧:
1 | 'abbccddd'.match(/(\w)\1*/g) // ["a", "bb", "cc", "ddd"] |
说明
拿到这个问题,首先要匹配字符[a-zA-Z0-9],这里直接使用\w。然后是全局匹配,在最后加上g。难点在于怎么判断重复。
翻看了犀牛书后,又读了一遍分组和引用的部分。使用小括号()将字符作为一个最小单元,同时小括号还能记忆这个组合相匹配的字符串。再使用反斜杠\引用前面分组的表达式,数字1表示第一个小括号。这时完成了2个字符重复的要求。最后再使用*来匹配出现0次或n次。这个正则表达式就写完了。
下面详细说说分组和引用。
正则表达式的选择、分组和引用字符表
| 字符 | 含义 |
|---|---|
| ` | ` |
(...) |
组合,将几个项组合为一个单元,这个单元可通过* + ? ` |
(?:...) |
只组合,把项组合到一个段元,但不记忆与该组相匹配的字符 |
\n |
和第n个分组第一次匹配的字符相匹配,组是圆括号中的子表达式(也有可能是嵌套的),组索引是从左到右的左括号数,(?:形式的分组不编码 |
对这个 jekyll 博客主题的改版和重构
- content
{:toc}
本文主要说明对这个博客主题的改版和代码重构的过程。这个简洁高雅的博客主题受到了很多朋友的喜欢。在写第一版界面时,我对前端并不是很熟悉,对Jekyll也不熟悉。现在距离当时也一年了,对自己当时写的代码也不太满意了,同时Jekyll如今也已经升级了,目前最新版为3.1.2。因此我在临近毕业尚未入职前做一下博客主题的代码重构和改版吧。
主要想做这些事情有:添加归档,添加标签,添加分类页面,主页显示文章摘要,代码去除 jQuery 和 BootStrap,优化移动端显示,将所有变量写入配置文件_config.yml中等。再优化一些细节吧。希望更多人会喜欢。
改版重构说明
使用 GitHub 风格的代码块 Markdown 写法 (Fenced code blocks)。
即 GFM(github flavored markdown) 的方式。
Jekyll 已经升级至 3.1.2(2016-03),其中有一些新的要注意的地方,比如官网上说使用了
Rouge去做代码高亮而不是默认的Pygments,因为Jekyll本身是基于 Ruby 的,因此我看到官方说希望不再使用基于 Python 的Pygments了,而是都使用基于 Ruby 的代码。详情见官网升级说明 syntax-highlighter-changed。首页中添加摘要
摘要可以在每一篇 md 文件头中使用 excerpt 属性写出来。也可以在正文中,4个换行符来分割,这个设置见配置文件
_config.yml。添加归档
上一版中没有归档,现在专门做了一个归档页面,当文章很多时方便根据年份快速查阅。
添加标签
标签还是很有必要添加的,上一版中也没有这个功能。现在也可以根据标签查找文章了。同时标签还有一个重要的作用是,用来获取相似文章的。
添加分类页
之前的分类就是在首页中直接完成的,现在和标签和归档类似,我将分类单独制作为一页,方便查阅。
去掉 jQuery 和 BootStrap
我觉得太重了,没必要使用这两个库,使用原生 JavaScript 和 CSS就可以做到一样的效果,代码量大大减轻,载入速度略有提高。
重写了demo页的瀑布流布局
改变数据写死的方式,将数据用 json 格式录入,由 JavaScript 拼接为 HTML 代码。同时,使用 Masonry,重写了瀑布流布局。
简化评论配置,支持 多说 和 disqus
在
_config.yml中评论配置直接添加自己的short_name,评论就能正常使用了。
下面列举一些可能遇到的问题,至少我是遇到了:
RubyGems 无法访问,SSL 证书问题
以前我使用的是 RubyGems 的淘宝镜像https://ruby.taobao.org/。现在这个镜像已经不再维护了,作者 huacnlee (李华顺) 转到 Ruby China 中继续维护了,详情见 RubyGems 镜像- Ruby China。
错误呈现
在执行任何gem命令的时候出现以下错误:
1 | ERROR: While executing gem ... (Gem::RemoteFetcher::FetchError) |
解决方法
根据 https://gems.ruby-china.org/ 页面最下方提供的 GitHub Issue 地址。
可以进入这个 issue:https://github.com/ruby-china/rubygems-mirror/issues/3
其中 sanlengjingvv 给出了一个链接地址 https://gist.github.com/fnichol/867550 里面提供了方法。我就是采用这里面的方法解决的。
我使用的是 The Manual Way,因为 The Ruby Way 我没有成功,不知道什么原因,有兴趣的朋友可以试试。下面说说我的具体操作吧。
首先从 https://curl.haxx.se/ca/cacert.pem 将文件cacert.pem下载至 C:\RailsInstaller\cacert.pem
然后执行
1 | set SSL_CERT_FILE=C:\RailsInstaller\cacert.pem |
就成功了,不会再出现 SSL 错误了。
最后原文中说,为了长久设置,将这个目录存入控制面板中。我没理解是什么意思,是指环境变量吗?有朋友知道的话,欢迎留言告知我。
我存入环境变量后,还是会出现 SSL 错误,这时再次执行上面那条命令即可。
jekyll-paginate 依赖缺失
因为 jekyll 3 中默认安装已经没有这个分页组件了,官方把这个分页组件插件化了,因此要独立安装。详情见 https://jekyllrb.com/docs/pagination/。
错误呈现
在启动 jekyll 服务的时候出现以下错误:
1 | jekyll serve |
解决方法
我们安装这个插件到本地即可。
1 | gem install jekyll-paginate |
被 Foxit pdf reader 占用4000端口
错误呈现
在本地使用命令
1 | jekyll serve |
出现错误,如下
1 | jekyll serve |
网上查阅后,这篇博文解决了我的问题。谁占了我的端口 for Windows –By Liu Xia, ThoughtWorks Senior Consultant. .NET Expert
上述报错主要原因是,jekyll 启动使用的4000端口被福昕pdf阅读器的自动更新进程占用了,关掉这个进程,jekyll在本地调试启动服务时就没有问题了。
解决方法
简单的解决方法是:
输入命令,查看各端口被占用情况
1 | netstat -ano |
找到4000端口被占用的PID
我的结果如下:
1 | 协议 本地地址 外部地址 状态 PID |
可以看到4000端口的PID是2476。下面查看是什么进程,命令行中输入:
1 | tasklist /svc /FI "PID eq 2476" |
得到结果:
1 | 映像名称 PID 服务 |
可以看到正是福昕阅读器。下面关掉这个服务就好了。在 win10 中进入任务管理器,选择服务选项卡,关闭这个服务就好了,如下图:

当然也可以在启动jekyll服务的时候指定端口号,如下:
1 | jekyll serve --port 3000 |
这样在浏览器中输入 http://localhost:3000/ 就可以访问了。
还可以在配置文件_config.yml中添加端口号设置(参考官网文档-Serve Command OptionsPermalink),如下:
1 | # port |
此时,启动jekyll服务后,访问 http://localhost:1234/ 即可
前端处理动态 url 和 pushStatus 的使用
- content
{:toc}
起因
起因是这样的,在尝试前后端分离的这条道路上,我自己也在不断摸索,感觉要把大部分的坑都踩踩了。目前我用的技术是:
- webpack 自动构建
- AMD 模块化 js
- Sass 预处理 CSS
- 使用前端模板引擎 handlebars 解决动态操作将 html 拼接在 js 中的问题
但最近写了一个项目类似知乎这样的多页网站。前端 url 的处理让我觉得不够优雅。我使用的是 hash 的方式处理动态 url 的,为此我专门在知乎上提了一个问题:前端如何处理动态url?
这里我将问题描述如下:
前后端彻底分离的情况下,页面跳转页全部由前端控制。那么如何更好的处理动态url地址?
例如本问题的url为
https://www.zhihu.com/question/38802932
这肯定是用后台路由处理的url纯前端怎么处理?用hash吗,如下:
https://www.zhihu.com/question#38802932
那如果本页跳转,只改变hash的话,页面不会刷新。
使用location.reload()倒是可以解决。但总觉得这样处理不够优雅。大家在工作中是如何处理此类场景的?还是用传统的后台路由来提供动态url?
感谢郑海波和剧中人的热心回答。都提到了history对象中的pushState,这是我第一次接触到这方面的内容(顿时觉得自己真是才疏学浅)。
同时也有人提到了pjax,这个就是pushState+Ajax的封装,也很有意思。
下面就来研究和实践一下吧。
History
window对象通过history对象提供对浏览器历史记录的访问能力。它暴露了一些非常有用的方法和属性,让你在历史记录中自由前进和后退,而在 HTML5 中,更可以操纵历史记录中的数据。
back(), forward(), go(), length
浏览器的历史记录就好像一个栈,最新的在最上面,较早之前看过的在下面。
如下图,Chrome的历史记录:

下面介绍怎么在这些历史记录中跳转,但要注意,上图中的浏览器历史记录和本文说的 history 还不太同。
back()在历史记录中后退
history.back();forward()在历史记录中前进
history.forward();go()移动到指定的历史记录点
history.go(-1);通过指定一个相对于当前页面位置的数值,你可以使用go()方法从当前会话的历史记录中加载页面(当前页面位置索引值为0,上一页就是-1,下一页为1)。
go()不填参数或参数为go(0)时,页面会刷新,即
history.go()或history.go(0)相当于location.reload()lengthlength为history的属性,显示history长度。
本节在线demo见:History & pjax demo 源代码:
经过亲自测试,history对象只记录同一个 tab 页内的历史。如果是在新窗口打开的,则无效。如:在a标签中添加target="_blank",或按住ctrl点击,这类场景下,在新的tab页中,history对象也是新的。
且history对象记录的信息与是否同源也无关,所以唯一要满足的就是同一个标签页。
pushState(), replaceState()
HTML5 引进了history.pushState()方法和history.replaceState()方法,它们允许你逐条地添加和修改历史记录条目,能够在不加载新页面的情况下没改变浏览器的URL。这些方法可以协同window.onpopstate事件一起工作。
使用history.pushState()会改变referrer的值,而在你调用方法后创建的 XMLHttpRequest 对象会在 HTTP 请求头中使用这个值。referrer的值则是创建 XMLHttpRequest 对象时所处的窗口的 URL。
pushState(any data, string title, [string url])第一个参数为
history对象的state属性值,可以放任意数据,记录历史状态。第二个参数是新状态的标题,目前浏览器基本不支持。第三个参数为可选的相对url。执行
pushState后,可以在不加载新页面的情况下,更改url。同时history栈中新增一条数据。例如,我们有这样一段代码:
  <button id="push1">pushState()</button>

  document.querySelector('#push1').addEventListener('click', function() {
      history.pushState('abc','pushStatePageTitle','pushState.html');
      document.querySelector('#length').innerHTML = history.length;//重新读取历史长度
  });
当点击按钮的时候,页面不会刷新,但
url地址的最后已经变为pushState.html。这一点非常像hash的作用,但比hash更优雅。replaceState(any data, string title, [string url])与
pushState()类似,只是在history栈中不是新增记录,而是替换一条记录。
需要注意的是:pushState()和replaceState()方法存在安全方面的限制,本地测试是无效的,会报错,可以简单放到任何服务端测试,或者使用http-server开启简单服务器,通过访问localhost来查看效果。
本节demo见:History & pjax demo - pushState
pjax
现在再看本文一开始提出的问题,如何让前端优雅的控制 url,这里就可以考虑 pjax 技术了。我们把 pushState + ajax 进行封装,合起来简称为 pjax。虽然不是什么新的技术,但概念已然不同。
如果不使用 pjax。我们依然可以使用hash来实现文本开始的需求。但会不利于 SEO,看着也不够优雅。
Pjax的原理十分简单。
- 拦截 a 标签的默认跳转动作或某些按钮的点击事件。
- 使用 Ajax 请求新页面。
- 将返回的 Html 替换到页面中。
- 使用 HTML5 的
pushState()修改Url。
个人理解3中也可以仅仅请求数据,再由浏览器渲染。
每当同一个文档的浏览历史(即history对象)出现变化时,会触发window.onpopstate事件。
window.onpopstate = function(event) {
    console.log(event.state);
    console.log(location);
};
这样在用户点击前进后退时也可以很好的监听url,来做相应的页面渲染。
若用户刷新了页面,但没有相应的页面资源,这时页面就会显示不存在。所以我认为较好的方法是在写pushState()第三个参数的时候,写为?a=1这样的参数形式。History.js 也是这么写的。但是这样应该会多一次请求。也许使用 nodeJS 作为中间层会好一些吧。
对于上述的探索,不知道是不是我还不够深入,总觉得还是不够完美。
参考
在低版本 IE 中点击空 block 元素的问题

Weinre --WebApp 调试工具
- content
{:toc}
什么是 weinre?
weinre官网 上有两句有意思的介绍:
weinre is WEb INspector REmote. Pronounced like the word “winery”. Or maybe like the word “weiner”. Who knows, really.
weinre is a debugger for web pages, like FireBug (for FireFox) and Web Inspector (for WebKit-based browsers), except it’s designed to work remotely, and in particular, to allow you debug web pages on a mobile device such as a phone.
上面说 weinre 是一个远程 web 调试器。说到了它的发音,还挺幽默,哈哈。
远程 web 调试器。先说调试器,就像火狐中的 FireBug,Chrome 中的调试器一样。就是在浏览器中按下 F12 出现的那个工具。但是在手机上,你没办法按 F12,而这个 weinre 就是在手机上的 F12,与传统的不同的是,它是在手机上浏览你的 web 页面,在 PC 上查看调试工具,非常方便,这就是所谓的远程。
为什么用 weinre?
现代浏览器中调试工具都非常强大了,可以直接模拟手机设备,为什么还要用 weinre 这么麻烦的东西呢?
我觉得 PC 端的浏览器虽说可以模拟,但模拟毕竟还是模拟,还只是鼠标长按滑来滑去。在开发过程中,使用手机或平板直接来感受是多么的酷,指尖在移动设备的屏幕上摩擦摩擦!给人的直观感受绝对秒杀浏览器的模拟。
原理
使用一种工具之前,了解它的原理和结构是很有帮助的。weinre 作为一种远程调试工具,在结构上分为三层:
- 目标页面(target):被调试的页面,页面已嵌入 weinre 的远程 js,下文会介绍;
- Debug客户端(client):本地的 Web Inspector 调试客户端;
- Debug服务端(agent):一个 HTTP Server,为目标页面与 Debug 客户端建立通信。
三层结构如下图所示:
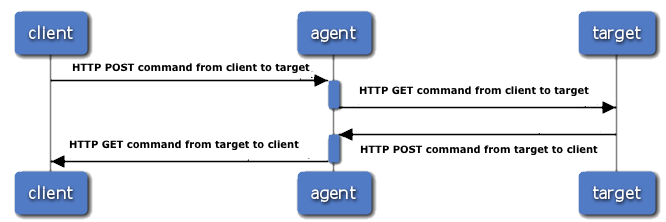
weinre 的 debug 客户端是基于 Web Inspector 开发,而 Web Inspector 只与以 WebKit 为核心的浏览器兼容,所以 Weinre 的客户端只能用 Chrome 或者 Safari 打开。
官网上也有相应的平台支持说明:
Platforms supported - debug server 服务端
任何支持 node.js 的平台。
Platforms supported - debug client 客户端(跑 debugger 界面的浏览器)
- Google Chrome
- Apple Safari
- Other recent-ish WebKit-based browsers 其他基于 webkit 内核的现代浏览器
Platforms supported - debug target 目标页面(在移动设备中调试运行的目标页面)
- Android Browser application
- iOS Mobile Safari application
- PhoneGap/Cordova
- other
安装
weinre 是 nodeJS 的一个应用,首先要 安装 nodeJS 运行环境
使用 npm 命令,安装 weinre
npm -g install weinre安装成功后会有类似的信息:
 C:\Users\haoyang\AppData\Roaming\npm\weinre -> C:\Users\haoyang\AppData\Roaming\npm\node_modules\weinre\weinre
 weinre@2.0.0-pre-I0Z7U9OV C:\Users\haoyang\AppData\Roaming\npm\node_modules\weinre
 ├── underscore@1.7.0
 ├── nopt@3.0.2 (abbrev@1.0.7)
 └── express@2.5.11 (mime@1.2.4, qs@0.4.2, mkdirp@0.3.0, connect@1.9.2)
使用
启动服务
weinre --boundHost -all- --httpPort 8081–boundHost [hostname | ip address | -all-]
The ip address to bind the server to.
–httpPort [portNumber]
The port to run the HTTP server on.
更多配置项参考 官网的说明。
启动成功后看到如下界面:

给目标页面添加一行脚本
可以看到 2.中的 Target Script 说要添加一行脚本到要调试的 web 页面中。
Target Script
You can use this script to inject the weinre target code into your web page.
http://localhost:8081/target/target-script-min.js#anonymous
Example:
<script src="http://localhost:8081/target/target-script-min.js#anonymous"></script>这里要说明一下,要把上面的 localhost 换为本机的 ip 地址。
我们可以在命令行中 使用
ipconfig得到 ip 地址,如下(当然你的可能和我的不一样):IPv4 地址 . . . . . . . . . . . . : 192.168.1.107即插入如下代码:
<script src="http://192.168.1.107:8081/target/target-script-min.js#anonymous"></script>进入调试页面
PC 端访问这个地址:
debug client user interface: http://localhost:8081/client/#anonymous
此时 target 为 none,如下图:

现在我们要用手机访问同一个局域网下的这个目标页面。我们可以把要调试的页面放到这个路径下:
C:\Users\haoyang\AppData\Roaming\npm\node_modules\weinre\web通过 http://192.168.1.107:8081/FILE_NAME 在手机上访问,就可以看到了。当然前提是同一个局域网。
但是这样可能不太灵活,每次都要把目标页面放到指定的目录下。所以我们可以另外开一个服务器。
我使用了基于 node.js 的 http-server 工具。将要调试的页面发布。这样我就能通过 ip 地址加端口号在手机上访问到了。
我在手机上访问 http://192.168.1.107:8080 打开要调试的页面,此时 debug client user interface 中自动检测到 target。就可以进行调试了!
如下图:


参考
Web App 相关技术
- content
{:toc}
往前推2到3年,前端工程师还在忧心忡忡地想,移动互联网时代下,前端是不是没有生存空间了。但今天一看,在我们团队,前端工程师超过一半的工作都是在做移动端的Web或者APP的开发。移动Web或者APP在技术本质上是和做桌面端Web没有本质区别,但是移动端的坑那是非常的多,通过学习这部分内容,让你成为一名桌面移动通吃的前端开发工程师。
概念
- 参考: 移动 Web 开发入门
上面这个 slide 资料讲的非常好,算是一个入门的介绍吧。带我们建立基本的移动 web 开发知识体系和常见问题的实践。包含以下几个方面:
基本概念
Native
本地应用 使用 Java \ Objective-C \ Swift 开发
WebApp
网页应用 html5 开发
Hybrid
混合应用 ooxx(native, web)
对比
视觉
- 设备的像素
- 文字单位使用 rem
- viewport 属性
- 横屏竖屏
- Flex 伸缩布局
- 响应式设计
- 软键盘
- 隐藏地址栏
- 苹果设备添加到主屏图标
交互
- Touch
- click 延迟
- Scroll
- Gestures(hammer –A javascript library for multi-touch gestures)
- 手指友好设计
- HTML5 APIS(图像,摇动,声音等)
实践
- 屏蔽点击元素时的阴影
- 图像(像素、矢量图标、base64 减少请求、lazyload)
- CSS3(合理使用渐变/圆角/阴影、代替 js 动画、translate3d、解决动画闪烁)
- localStorage
- 避免(iframe、fixed + input)
- SPA 或 Multi page
- can I use
- 压缩合并
- @G/3G 下建立连接时间
调试
浏览器自己的调试工具,模拟手机设备
weinre
关于 weinre 我写了一篇博客介绍它。Weinre –WebApp 调试工具
head 标签
参考:
上面的链接详细的讲解了:
DOCTYPE
charset
lang属性
优先使用 IE 最新版本和 Chrome
360 使用Google Chrome Frame
SEO 优化部分:页面标题
标签(head 头部必须),页面关键词 keywords,页面描述内容 description,定义网页作者 author,网页搜索引擎索引方式</p> </li> <li><p>为移动设备添加 viewport</p> <p> <code>viewport</code> 可以让布局在移动浏览器上显示的更好。 通常会写</p> </li> </ul> <figure class="highlight html"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><span class="line"><span class="tag"><<span class="name">meta</span> <span class="attr">name</span> =<span class="string">"viewport"</span> <span class="attr">content</span> =<span class="string">"initial-scale=1, maximum-scale=3, minimum-scale=1, user-scalable=no"</span>></span></span><br><span class="line"><span class="comment"><!-- `width=device-width` 会导致 iPhone 5 添加到主屏后以 WebApp 全屏模式打开页面时出现黑边 http://bigc.at/ios-webapp-viewport-meta.orz --></span></span><br></pre></td></tr></table></figure> <ul> <li><p>content 参数:</p> <ul> <li>width viewport 宽度(数值/device-width)</li> <li>height viewport 高度(数值/device-height)</li> <li>initial-scale 初始缩放比例</li> <li>maximum-scale 最大缩放比例</li> <li>minimum-scale 最小缩放比例</li> <li>user-scalable 是否允许用户缩放(yes/no)</li> </ul> </li> <li><p>ios 设备,iOS 图标,Android,Windows 8</p> </li> </ul> <p><strong>总结:</strong></p> <figure class="highlight html"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br><span class="line">72</span><br><span class="line">73</span><br><span class="line">74</span><br><span class="line">75</span><br><span class="line">76</span><br><span class="line">77</span><br><span class="line">78</span><br><span class="line">79</span><br><span class="line">80</span><br><span class="line">81</span><br><span class="line">82</span><br><span class="line">83</span><br><span class="line">84</span><br><span class="line">85</span><br><span class="line">86</span><br><span class="line">87</span><br><span class="line">88</span><br><span class="line">89</span><br><span class="line">90</span><br><span class="line">91</span><br><span class="line">92</span><br><span class="line">93</span><br><span class="line">94</span><br><span class="line">95</span><br><span class="line">96</span><br></pre></td><td class="code"><pre><span class="line"><span class="meta"><!DOCTYPE <span class="keyword">html</span>></span> <span class="comment"><!-- 使用 HTML5 doctype,不区分大小写 --></span></span><br><span class="line"><span class="tag"><<span class="name">html</span> <span class="attr">lang</span>=<span class="string">"zh-cmn-Hans"</span>></span> <span class="comment"><!-- 更加标准的 lang 属性写法 http://zhi.hu/XyIa --></span></span><br><span class="line"><span class="tag"><<span class="name">head</span>></span></span><br><span class="line"> <span class="comment"><!-- 声明文档使用的字符编码 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">charset</span>=<span class="string">'utf-8'</span>></span></span><br><span class="line"> <span class="comment"><!-- 优先使用 IE 最新版本和 Chrome --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">http-equiv</span>=<span class="string">"X-UA-Compatible"</span> <span class="attr">content</span>=<span class="string">"IE=edge,chrome=1"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 页面描述 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"description"</span> <span class="attr">content</span>=<span class="string">"不超过150个字符"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 页面关键词 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"keywords"</span> <span class="attr">content</span>=<span class="string">""</span>/></span></span><br><span class="line"> <span class="comment"><!-- 网页作者 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"author"</span> <span class="attr">content</span>=<span class="string">"name, email@gmail.com"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 搜索引擎抓取 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"robots"</span> <span class="attr">content</span>=<span class="string">"index,follow"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 为移动设备添加 viewport --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"viewport"</span> <span class="attr">content</span>=<span class="string">"initial-scale=1, maximum-scale=3, minimum-scale=1, user-scalable=no"</span>></span></span><br><span class="line"> <span class="comment"><!-- `width=device-width` 会导致 iPhone 5 添加到主屏后以 WebApp 全屏模式打开页面时出现黑边 http://bigc.at/ios-webapp-viewport-meta.orz --></span></span><br><span class="line"></span><br><span class="line"> <span class="comment"><!-- iOS 设备 begin --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"apple-mobile-web-app-title"</span> <span class="attr">content</span>=<span class="string">"标题"</span>></span></span><br><span class="line"> <span class="comment"><!-- 添加到主屏后的标题(iOS 6 新增) --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"apple-mobile-web-app-capable"</span> <span class="attr">content</span>=<span class="string">"yes"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 是否启用 WebApp 全屏模式,删除苹果默认的工具栏和菜单栏 --></span></span><br><span class="line"></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"apple-itunes-app"</span> <span class="attr">content</span>=<span class="string">"app-id=myAppStoreID, affiliate-data=myAffiliateData, app-argument=myURL"</span>></span></span><br><span class="line"> <span class="comment"><!-- 添加智能 App 广告条 Smart App Banner(iOS 6+ Safari) --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"apple-mobile-web-app-status-bar-style"</span> <span class="attr">content</span>=<span class="string">"black"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 设置苹果工具栏颜色 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"format-detection"</span> <span class="attr">content</span>=<span class="string">"telphone=no, email=no"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 忽略页面中的数字识别为电话,忽略email识别 --></span></span><br><span class="line"> <span class="comment"><!-- 启用360浏览器的极速模式(webkit) --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"renderer"</span> <span class="attr">content</span>=<span class="string">"webkit"</span>></span></span><br><span class="line"> <span class="comment"><!-- 避免IE使用兼容模式 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">http-equiv</span>=<span class="string">"X-UA-Compatible"</span> <span class="attr">content</span>=<span class="string">"IE=edge"</span>></span></span><br><span class="line"> <span class="comment"><!-- 针对手持设备优化,主要是针对一些老的不识别viewport的浏览器,比如黑莓 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"HandheldFriendly"</span> <span class="attr">content</span>=<span class="string">"true"</span>></span></span><br><span class="line"> <span class="comment"><!-- 微软的老式浏览器 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"MobileOptimized"</span> <span class="attr">content</span>=<span class="string">"320"</span>></span></span><br><span class="line"> <span class="comment"><!-- uc强制竖屏 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"screen-orientation"</span> <span class="attr">content</span>=<span class="string">"portrait"</span>></span></span><br><span class="line"> <span class="comment"><!-- QQ强制竖屏 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"x5-orientation"</span> <span class="attr">content</span>=<span class="string">"portrait"</span>></span></span><br><span class="line"> <span class="comment"><!-- UC强制全屏 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"full-screen"</span> <span class="attr">content</span>=<span class="string">"yes"</span>></span></span><br><span class="line"> <span class="comment"><!-- QQ强制全屏 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"x5-fullscreen"</span> <span class="attr">content</span>=<span class="string">"true"</span>></span></span><br><span class="line"> <span class="comment"><!-- UC应用模式 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"browsermode"</span> <span class="attr">content</span>=<span class="string">"application"</span>></span></span><br><span class="line"> <span class="comment"><!-- QQ应用模式 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"x5-page-mode"</span> <span class="attr">content</span>=<span class="string">"app"</span>></span></span><br><span class="line"> <span class="comment"><!-- windows phone 点击无高光 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"msapplication-tap-highlight"</span> <span class="attr">content</span>=<span class="string">"no"</span>></span></span><br><span class="line"> <span class="comment"><!-- iOS 图标 begin --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-icon-precomposed"</span> <span class="attr">href</span>=<span class="string">"/apple-touch-icon-57x57-precomposed.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPhone 和 iTouch,默认 57x57 像素,必须有 --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-icon-precomposed"</span> <span class="attr">sizes</span>=<span class="string">"114x114"</span> <span class="attr">href</span>=<span class="string">"/apple-touch-icon-114x114-precomposed.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- Retina iPhone 和 Retina iTouch,114x114 像素,可以没有,但推荐有 --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-icon-precomposed"</span> <span class="attr">sizes</span>=<span class="string">"144x144"</span> <span class="attr">href</span>=<span class="string">"/apple-touch-icon-144x144-precomposed.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- Retina iPad,144x144 像素,可以没有,但推荐有 --></span></span><br><span class="line"> <span class="comment"><!-- iOS 图标 end --></span></span><br><span class="line"></span><br><span class="line"> <span class="comment"><!-- iOS 启动画面 begin --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"768x1004"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-768x1004.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPad 竖屏 768 x 1004(标准分辨率) --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"1536x2008"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-1536x2008.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPad 竖屏 1536x2008(Retina) --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"1024x748"</span> <span class="attr">href</span>=<span class="string">"/Default-Portrait-1024x748.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPad 横屏 1024x748(标准分辨率) --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"2048x1496"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-2048x1496.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPad 横屏 2048x1496(Retina) --></span></span><br><span class="line"></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-320x480.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPhone/iPod Touch 竖屏 320x480 (标准分辨率) --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"640x960"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-640x960.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPhone/iPod Touch 竖屏 640x960 (Retina) --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"apple-touch-startup-image"</span> <span class="attr">sizes</span>=<span class="string">"640x1136"</span> <span class="attr">href</span>=<span class="string">"/splash-screen-640x1136.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- iPhone 5/iPod Touch 5 竖屏 640x1136 (Retina) --></span></span><br><span class="line"> <span class="comment"><!-- iOS 启动画面 end --></span></span><br><span class="line"></span><br><span class="line"> <span class="comment"><!-- iOS 设备 end --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"msapplication-TileColor"</span> <span class="attr">content</span>=<span class="string">"#000"</span>/></span></span><br><span class="line"> <span class="comment"><!-- Windows 8 磁贴颜色 --></span></span><br><span class="line"> <span class="tag"><<span class="name">meta</span> <span class="attr">name</span>=<span class="string">"msapplication-TileImage"</span> <span class="attr">content</span>=<span class="string">"icon.png"</span>/></span></span><br><span class="line"> <span class="comment"><!-- Windows 8 磁贴图标 --></span></span><br><span class="line"></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"alternate"</span> <span class="attr">type</span>=<span class="string">"application/rss+xml"</span> <span class="attr">title</span>=<span class="string">"RSS"</span> <span class="attr">href</span>=<span class="string">"/rss.xml"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 添加 RSS 订阅 --></span></span><br><span class="line"> <span class="tag"><<span class="name">link</span> <span class="attr">rel</span>=<span class="string">"shortcut icon"</span> <span class="attr">type</span>=<span class="string">"image/ico"</span> <span class="attr">href</span>=<span class="string">"/favicon.ico"</span>/></span></span><br><span class="line"> <span class="comment"><!-- 添加 favicon icon --></span></span><br><span class="line"></span><br><span class="line"> <span class="tag"><<span class="name">title</span>></span>标题<span class="tag"></<span class="name">title</span>></span></span><br><span class="line"><span class="tag"></<span class="name">head</span>></span></span><br><span class="line"><span class="tag"><<span class="name">body</span>></span></span><br><span class="line"><span class="tag"></<span class="name">body</span>></span></span><br><span class="line"><span class="tag"></<span class="name">html</span>></span></span><br></pre></td></tr></table></figure> <h2 id="页面切换动画"><a href="#页面切换动画" class="headerlink" title="页面切换动画"></a>页面切换动画</h2><ul> <li><a target="_blank" rel="noopener" href="http://www.w3cplus.com/mobile/mobile-terminal-refactoring-slider.html">移动端重构系列13——页面切换</a></li> <li><a target="_blank" rel="noopener" href="http://www.w3cplus.com/css3/css3-3d-transform.html">CSS3 3D Transform</a></li> </ul> <p>关于 HammerJS 的一个中文文档</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/iamlilinfeng/p/4239957.html">Hammer.js</a></li> </ul> <hr> <h2 id="CSS-Processing"><a href="#CSS-Processing" class="headerlink" title="CSS Processing"></a>CSS Processing</h2><blockquote> <p>CSS语言由于其自身语言设计的问题,加上一些浏览器兼容性问题,往往会使得我们在写它的时候,要写很多冗余代码,或者为了兼容性对同一个样式设定写好几遍。针对这些问题,诞生了CSS预处理和后处理的概念及相关方法、工具。</p> <p>这些工具和方法帮助我们能够更加高效地书写可维护性更强的CSS代码。</p> </blockquote> <p>这里我尝试使用了 Sass,果然很好用。下面记录几个 sass 教程。</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.w3cplus.com/sassguide/">Sass入门-w3cplus</a></li> <li><a target="_blank" rel="noopener" href="http://www.ruanyifeng.com/blog/2012/06/sass.html">SASS用法指南-阮一峰</a></li> </ul> <h3 id="安装"><a href="#安装" class="headerlink" title="安装"></a>安装</h3><p>首先要有 ruby 环境。</p> <p>由于国内网络原因(你懂的),导致 rubygems.org 存放在 Amazon S3 上面的资源文件间歇性连接失败。这时候我们可以通过gem sources命令来配置源,先移除默认的 <a target="_blank" rel="noopener" href="https://rubygems.org/">https://rubygems.org</a> 源,然后添加淘宝的源 <a target="_blank" rel="noopener" href="https://ruby.taobao.org/%EF%BC%8C%E7%84%B6%E5%90%8E%E6%9F%A5%E7%9C%8B%E4%B8%8B%E5%BD%93%E5%89%8D%E4%BD%BF%E7%94%A8%E7%9A%84%E6%BA%90%E6%98%AF%E5%93%AA%E4%B8%AA%EF%BC%8C%E5%A6%82%E6%9E%9C%E6%98%AF%E6%B7%98%E5%AE%9D%E7%9A%84%EF%BC%8C%E5%88%99%E8%A1%A8%E7%A4%BA%E5%8F%AF%E4%BB%A5%E8%BE%93%E5%85%A5">https://ruby.taobao.org/,然后查看下当前使用的源是哪个,如果是淘宝的,则表示可以输入</a> sass 安装命令 <code>gem install sass</code> 了。</p> <pre><code>$ gem sources --remove https://rubygems.org/ $ gem sources -a https://ruby.taobao.org/ $ gem sources -l *** CURRENT SOURCES *** https://ruby.taobao.org # 请确保只有 ruby.taobao.org $ gem install sass </code></pre> <h3 id="编译"><a href="#编译" class="headerlink" title="编译"></a>编译</h3><pre><code>sass --watch style.scss:style.css --style expanded </code></pre> <hr> <h3 id="补充"><a href="#补充" class="headerlink" title="补充"></a>补充</h3><p><strong><code>rem</code></strong></p> <p>字体单位使用 rem,用户在手机上设置了字体大小时,不会打破布局,造成混乱。</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.w3cplus.com/css3/define-font-size-with-css3-rem">CSS3的REM设置字体大小-w3cplus</a></li> <li><a target="_blank" rel="noopener" href="http://www.iyunlu.com/view/css-xhtml/76.html">响应式十日谈第一日:使用 rem 设置文字大小-一丝</a></li> </ul> <hr> <h2 id="安全"><a href="#安全" class="headerlink" title="安全"></a>安全</h2><blockquote> <p>安全是大家经常容易忽视,但其实一旦出现影响会非常大的问题,尤其对于没有经历过企业开发,或者没有踩过坑的同学,如果等到公司工作,做实际项目后非常容易发生安全问题。</p> </blockquote> <h3 id="分类"><a href="#分类" class="headerlink" title="分类"></a>分类</h3><p>WEB基本攻击大致可以分为三大类:“资源枚举”、“参数操纵” 和 “其它攻击”</p> <ul> <li>资源枚举</li> <li>参数操纵<ul> <li>SQL注入</li> <li>XPath注入</li> <li>cgi命令执行</li> <li>XXS(cross-site scripting跨域脚本攻击)其重点是“跨域”和“客户端执行”<ul> <li>Reflected XSS ——基于反射的XSS攻击。主要依靠站点服务端返回脚本,在客户端触发执行从而发起WEB攻击。</li> <li>DOM-based or local XSS——基于DOM或本地的XSS攻击</li> <li>Stored XSS——基于存储的XSS攻击</li> </ul> </li> <li>会话劫持</li> </ul> </li> <li>其它攻击<ul> <li>CSRF(cross-site request forgery)跨站请求伪造</li> <li>钓鱼攻击指的是网站的伪造,比如ta0bao.com,然后在其中应用XSS等方式发起攻击。</li> <li>拒绝服务(DoS)指的是向网站发起洪水一样的请求(Traffic Floor),导致服务器超负荷并关闭,处理方法常规是采用QoS(Quality of Service)的软硬件解决方案。</li> </ul> </li> </ul> <h3 id="关于-XSS"><a href="#关于-XSS" class="headerlink" title="关于 XSS"></a>关于 XSS</h3><blockquote> <p><strong>跨网站脚本</strong>(Cross-site scripting,通常简称为XSS或跨站脚本或跨站脚本攻击)是一种网站应用程序的安全漏洞攻击,是代码注入的一种。它允许恶意用户将代码注入到网页上,其他用户在观看网页时就会受到影响。这类攻击通常包含了HTML以及用户端脚本语言。</p> <p>XSS攻击通常指的是通过利用网页开发时留下的漏洞,通过巧妙的方法注入恶意指令代码到网页,使用户加载并执行攻击者恶意制造的网页程序。这些恶意网页程序通常是JavaScript,但实际上也可以包括Java, VBScript, ActiveX, Flash 或者甚至是普通的HTML。攻击成功后,攻击者可能得到更高的权限(如执行一些操作)、私密网页内容、会话和cookie等各种内容。</p> <p>——维基百科</p> </blockquote> <h3 id="XSS-防护"><a href="#XSS-防护" class="headerlink" title="XSS 防护"></a>XSS 防护</h3><ol> <li><p>浏览器解析顺序:</p> <p> HTML Parser >> CSS Parser >> JavaScript Parser</p> </li> <li><p>浏览器解码顺序:</p> <p> HTML Decoding >> URL Decoding >> JavaScript Decoding</p> </li> <li><p>具体的防护方式:</p> <ul> <li>验证输入并且基于语境和按照正确的顺序转义不可信数据<ul> <li>HTML 中的字符串</li> <li>HTML 属性中的字符串</li> <li>事件句柄属性和 JavaScript 中的字符串</li> <li>HTML 属性中的 URL 路径</li> <li>HTML 风格属性和 CSS 中的字符串</li> <li>JavaScript 中的 HTML</li> </ul> </li> <li>始终遵循白名单优于黑名单的做法</li> <li>使用 UTF-8 为默认的字符编码以及设置 content 为 text/html</li> <li>不要将用户可以控制的文本放在<meta>标签前。通过使用不同的字符集注射可以导致 XSS。</li> <li>使用 <!DOCTYPE html></li> <li>使用推荐的 HTTP 响应头进行 XSS 防护</li> <li>防止 CRLF 注入/HTTP 响应拆分</li> <li>禁止 TRACE 和其他非必要方法</li> </ul> </li> </ol> <p>对于 innerHTML 的方式输出的,我们可以采用如下的方式转码</p> <figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><span class="line"><span class="comment">/**</span></span><br><span class="line"><span class="comment"> * 转码 XSS 防护</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@param</span> {<span class="type">String</span>} str 用户输入的字符串</span></span><br><span class="line"><span class="comment"> * <span class="doctag">@return</span> {<span class="type">String</span>} 转码后的字符串</span></span><br><span class="line"><span class="comment"> */</span></span><br><span class="line"><span class="keyword">function</span> <span class="title function_">changeCode</span>(<span class="params">str</span>) {</span><br><span class="line"> str = str.<span class="title function_">replace</span>(<span class="regexp">/&/g</span>, <span class="string">"&"</span>)</span><br><span class="line"> .<span class="title function_">replace</span>(<span class="regexp">/</g</span>, <span class="string">"<"</span>)</span><br><span class="line"> .<span class="title function_">replace</span>(<span class="regexp">/>/g</span>, <span class="string">">"</span>)</span><br><span class="line"> .<span class="title function_">replace</span>(<span class="regexp">/"/g</span>, <span class="string">"""</span>)</span><br><span class="line"> .<span class="title function_">replace</span>(<span class="regexp">/'/g</span>, <span class="string">"'"</span>)</span><br><span class="line"> .<span class="title function_">replace</span>(<span class="regexp">/\//g</span>, <span class="string">"/"</span>);</span><br><span class="line"> <span class="keyword">return</span> str;</span><br><span class="line">}</span><br></pre></td></tr></table></figure> <hr> <p>参考:</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/vajoy/p/4176908.html">浅谈WEB安全性(前端向)</a></li> <li><a target="_blank" rel="noopener" href="http://www.freebuf.com/articles/web/40520.html">XSS的原理分析与解剖</a></li> <li><a target="_blank" rel="noopener" href="http://www.fooying.com/chinese-translationthe-ultimate-xss-protection-cheatsheet-for-developers/">原创翻译:给开发者的终极XSS防护备忘录</a></li> </ul> <hr> <h2 id="性能优化"><a href="#性能优化" class="headerlink" title="性能优化"></a>性能优化</h2><blockquote> <p>在自己做一些小项目时,可能是学校的一些网站项目,流量可能日均都不超过500,而且大多是校园局域网内访问;或者是开发一些实验室的MIS系统,这辈子你都不会去使用你开发的这个系统。在这样一些项目中,性能优化往往会被你忽略。</p> <p>但是如果你是做一个日均PV数万、数十万、甚至更大的量级,开发的页面会被全国各地,不同网络条件的用户来进行访问。这个时候,性能问题就无法忽视了。在当今的网络条件下,如果你的页面3秒都无法完成首屏渲染,一定会让你的网站流失很多用户。</p> <p>整个网站的性能优化有很多的环节和工作,大多数时候,不是前端工程师单独就能完成的,尤其在职能划分明确的公司中,往往需要前后端、运维、DBA等多个职位协同完成。所以,在我们的课程中,主要让你了解整个性能优化都涉及哪些方面的工作,同时,我们会专注介绍一些在前端领域可以重点关注的技术点。</p> </blockquote> <p>这里就是网页的打开速度,如果你的网页打开速度很慢,那么一定会有用户的流失。所以性能优化很重要。</p> <ul> <li>网页内容<ul> <li>减少http请求次数</li> <li>减少DNS查询次数</li> <li>避免页面跳转</li> <li>缓存Ajax</li> <li>延迟加载</li> <li>提前加载</li> <li>减少DOM元素数量</li> <li>根据域名划分内容</li> <li>减少iframe数量</li> <li>避免404</li> </ul> </li> <li>服务器<ul> <li>使用CDN</li> <li>添加Expires 或Cache-Control报文头</li> <li>Gzip压缩传输文件</li> <li>配置ETags</li> <li>尽早flush输出</li> <li>使用GET Ajax请求</li> <li>避免空的图片src</li> </ul> </li> <li>Cookie<ul> <li>减少Cookie大小</li> <li>页面内容使用无cookie域名</li> </ul> </li> <li>CSS<ul> <li>将样式表置顶</li> <li>避免CSS表达式</li> <li>用<link>代替@import</li> <li>避免使用Filters</li> </ul> </li> <li>Javascript<ul> <li>将脚本置底</li> <li>使用外部Javascirpt和CSS文件</li> <li>精简Javascript和CSS</li> <li>去除重复脚本</li> <li>减少DOM访问</li> <li>使用智能事件处理</li> </ul> </li> <li>图片<ul> <li>优化图像</li> <li>优化CSS Sprite</li> <li>不要在HTML中缩放图片</li> <li>使用小且可缓存的favicon.ico</li> </ul> </li> <li>移动客户端<ul> <li>保持单个内容小于25KB</li> <li>打包组建成符合文档</li> </ul> </li> </ul> <p>具体细节参考文章:</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/developersupport/p/webpage-performance-best-practices.html">毫秒必争,前端网页性能最佳实践</a></li> </ul> <p>我在 ToDo 这个任务中主要使用了 CDN 来加载静态资源。比如我使用了 <a target="_blank" rel="noopener" href="http://cdn.code.baidu.com/">百度静态资源公共库</a>。引用了里面的 fontawesome,速度果然比在 GitHub 仓库里快很多。下一步是压缩我自己写的静态资源。</p> <p>其他参考资料:</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.oschina.net/translate/front-end-performance-for-web-designers-and-front-end-developers#section:maximising-parallelisation">给网页设计师和前端开发者看的前端性能优化</a></li> <li><a target="_blank" rel="noopener" href="http://www.zhangxinxu.com/wordpress/?p=3152">梳理:提高前端性能方面的处理以及不足</a></li> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/mofish/archive/2010/10/12/1849062.html">css sprite原理优缺点及使用</a></li> <li><a target="_blank" rel="noopener" href="http://www.qianduan.net/css-sprites-useful-technique-or-potential-nuisance/">CSS Sprites:鱼翅还是三鹿?</a></li> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/leefreeman/p/3998757.html">大型网站的灵魂——性能</a></li> <li><a target="_blank" rel="noopener" href="http://web.jobbole.com/35339/">编写高效的 CSS 选择器</a></li> </ul> <hr> <h2 id="模块化"><a href="#模块化" class="headerlink" title="模块化"></a>模块化</h2><blockquote> <p>对于一个复杂项目,特别是多人协作的复杂项目,如何合理划分模块,如何更加方便地进行模块加载,如何管理模块之间的依赖,是一个项目团队都会面临的问题,目前业界已经有了一些较为普遍的解决方案,如AMD。这个部分希望你能够通过学习JavaScript的模块化,学习如何合理地规划项目模块,合理使用模块化工具来优化你的项目代码结构。</p> </blockquote> <p>一个模块就是实现特定功能的文件,有了模块,我们就可以更方便地使用别人的代码,想要什么功能,就加载什么模块。模块开发需要遵循一定的规范,否则就都乱套了。</p> <p>根据AMD规范,我们可以使用 <code>define</code> 定义模块,使用 <code>require</code> 调用模块。</p> <p>目前,通行的 js 模块规范主要有两种:<code>CommonJS</code> 和 <code>AMD</code>。</p> <h3 id="AMD规范"><a href="#AMD规范" class="headerlink" title="AMD规范"></a>AMD规范</h3><p>AMD 即 Asynchronous Module Definition,中文名是“异步模块定义”的意思。它是一个在浏览器端模块化开发的规范,服务器端的规范是 CommonJS</p> <p>模块将被异步加载,模块加载不影响后面语句的运行。所有依赖某些模块的语句均放置在回调函数中。</p> <p>AMD 是 RequireJS 在推广过程中对模块定义的规范化的产出。</p> <p>详细 API 如下:</p> <ul> <li><a target="_blank" rel="noopener" href="https://github.com/amdjs/amdjs-api/wiki/AMD-(%E4%B8%AD%E6%96%87%E7%89%88)">AMD(中文版)</a></li> </ul> <hr> <h3 id="CommonJS规范"><a href="#CommonJS规范" class="headerlink" title="CommonJS规范"></a>CommonJS规范</h3><p>CommonJS 是服务器端模块的规范,Node.js 采用了这个规范。Node.JS 首先采用了 js 模块化的概念。</p> <p>根据 CommonJS 规范,一个单独的文件就是一个模块。每一个模块都是一个单独的作用域,也就是说,在该模块内部定义的变量,无法被其他模块读取,除非定义为 global 对象的属性。</p> <p>输出模块变量的最好方法是使用 module.exports 对象。</p> <hr> <h3 id="为什么要用-requireJS"><a href="#为什么要用-requireJS" class="headerlink" title="为什么要用 requireJS"></a>为什么要用 requireJS</h3><p>试想一下,如果一个网页有很多的js文件,那么浏览器在下载该页面的时候会先加载js文件,从而停止了网页的渲染,如果文件越多,浏览器可能失去响应。其次,要保证js文件的依赖性,依赖性最大的模块(文件)要放在最后加载,当依赖关系很复杂的时候,代码的编写和维护都会变得困难。</p> <p>RequireJS就是为了解决这两个问题而诞生的:</p> <blockquote> <p>(1)实现js文件的异步加载,避免网页失去响应;<br>(2)管理模块之间的依赖性,便于代码的编写和维护。</p> </blockquote> <h4 id="requireJS"><a href="#requireJS" class="headerlink" title="requireJS"></a>requireJS</h4><ul> <li><a target="_blank" rel="noopener" href="http://requirejs.org/">requireJS 官网</a></li> <li><a target="_blank" rel="noopener" href="http://www.requirejs.cn/">requireJS 中文网</a></li> </ul> <hr> <h3 id="AMD和CMD"><a href="#AMD和CMD" class="headerlink" title="AMD和CMD"></a>AMD和CMD</h3><p>CMD(Common Module Definition) 通用模块定义。该规范明确了模块的基本书写格式和基本交互规则。该规范是在国内发展出来的。AMD是依赖关系前置,CMD是按需加载。</p> <blockquote> <p>AMD 是 RequireJS 在推广过程中对模块定义的规范化产出。<br>CMD 是 SeaJS 在推广过程中对模块定义的规范化产出。</p> </blockquote> <ul> <li><a target="_blank" rel="noopener" href="https://github.com/seajs/seajs/issues/242">CMD 模块定义规范</a></li> </ul> <p>对于依赖的模块,AMD 是提前执行,CMD 是延迟执行。</p> <blockquote> <p>AMD:提前执行(异步加载:依赖先执行)+延迟执行<br>CMD:延迟执行(运行到需加载,根据顺序执行)</p> </blockquote> <hr> <h3 id="参考"><a href="#参考" class="headerlink" title="参考"></a>参考</h3><ul> <li><a target="_blank" rel="noopener" href="http://www.ruanyifeng.com/blog/2012/10/javascript_module.html">Javascript模块化编程(一):模块的写法–阮一峰</a></li> <li><a target="_blank" rel="noopener" href="http://www.ruanyifeng.com/blog/2012/10/asynchronous_module_definition.html">Javascript模块化编程(二):AMD规范</a></li> <li><a target="_blank" rel="noopener" href="http://www.ruanyifeng.com/blog/2012/11/require_js.html">Javascript模块化编程(三):require.js的用法</a></li> <li><a target="_blank" rel="noopener" href="http://segmentfault.com/a/1190000000733959">详解 JavaScript 模块开发</a></li> <li><a target="_blank" rel="noopener" href="http://www.cnblogs.com/jinguangguo/archive/2013/04/06/3002515.html?utm_source=tuicool">浅谈模块化的JavaScript</a></li> <li><a target="_blank" rel="noopener" href="http://div.io/topic/430">再谈 SeaJS 与 RequireJS 的差异</a></li> <li>玩转AMD系列 by erik@EFE<ul> <li><a target="_blank" rel="noopener" href="http://efe.baidu.com/blog/dissecting-amd-preface/">玩转AMD - 写在前面</a></li> <li><a target="_blank" rel="noopener" href="http://efe.baidu.com/blog/dissecting-amd-what/">玩转AMD - 设计思路</a></li> <li><a target="_blank" rel="noopener" href="http://efe.baidu.com/blog/dissecting-amd-how/">玩转AMD - 应用实践</a></li> <li><a target="_blank" rel="noopener" href="http://efe.baidu.com/blog/dissecting-amd-loader/">玩转AMD - Loader</a></li> </ul> </li> </ul> <hr> <h2 id="前端工程化"><a href="#前端工程化" class="headerlink" title="前端工程化"></a>前端工程化</h2><blockquote> <p>业界目前有非常多的前端开发工具,完成一些开发过程中可以自动化完成的工作,提高研发效率,并且可以提高多人协作时的开发过程一致性,提高整个项目的运维效率。</p> <p>在EFE日常工作中,我们是基于EDP,完成项目开发过程中的项目构建、包管理、调试、单测、静态检测、打包、压缩、优化、项目部署等一系列所有工作。</p> </blockquote> <p>注:</p> <p>如果网络不好,可以使用 <a target="_blank" rel="noopener" href="http://npm.taobao.org/">淘宝 NPM 镜像</a>。</p> <h3 id="参考-1"><a href="#参考-1" class="headerlink" title="参考"></a>参考</h3><ul> <li><a target="_blank" rel="noopener" href="http://div.io/topic/439">前端工程与模块化框架</a></li> <li><a target="_blank" rel="noopener" href="http://mweb.baidu.com/p/baidusearch-front-end-road.html">手机百度前端工程化之路</a></li> <li><a target="_blank" rel="noopener" href="http://www.infoq.com/cn/articles/yunlong-on-fis">对话百度前端工程师张云龙:F.I.S与前端工业化</a></li> <li><a target="_blank" rel="noopener" href="https://github.com/ecomfe/edp">EDP</a></li> <li><a target="_blank" rel="noopener" href="http://www.w3cplus.com/tools/grunt-tutorial-start-grunt.html">Grunt教程——初涉Grunt</a></li> <li><a target="_blank" rel="noopener" href="http://www.open-open.com/lib/view/open1417068223049.html">gulp入门指南</a></li> <li><a target="_blank" rel="noopener" href="http://www.w3ctech.com/topic/134">Gulp开发教程(翻译)</a></li> <li><a target="_blank" rel="noopener" href="http://www.gulpjs.com.cn/">Gulp 中文网</a></li> <li><a target="_blank" rel="noopener" href="https://github.com/ericdum/mujiang.info/issues/6">npm的package.json中文文档</a></li> </ul> <hr> <h2 id="最终作品"><a href="#最终作品" class="headerlink" title="最终作品"></a>最终作品</h2><p>在任务三中,做了一个 PC 端的 ToDo 应用。任务四是将它优化,以适应移动端设备。</p> <h3 id="ToDo-WebApp-Version"><a href="#ToDo-WebApp-Version" class="headerlink" title="ToDo WebApp Version"></a>ToDo WebApp Version</h3><ul> <li><p><a target="_blank" rel="noopener" href="https://github.com/baidu-ife/ife/tree/master/task/task0004">任务四要求</a></p> </li> <li><p><a target="_blank" rel="noopener" href="https://github.com/Gaohaoyang/ToDo-WebApp">源代码</a></p> </li> <li><p><a target="_blank" rel="noopener" href="http://gaohaoyang.github.io/ToDo-WebApp/">在线 demo</a></p> </li> <li><p>手机查看 ↓ 二维码 ↓</p> <p> <img src="http://7q5cdt.com1.z0.glb.clouddn.com/task4-code-todoWebApp.png" alt="todoWebApp"></p> </li> <li><p><a target="_blank" rel="noopener" href="http://gaohaoyang.github.io/">我的博客 HyG</a></p> </li> </ul> <h3 id="Details"><a href="#Details" class="headerlink" title="Details"></a>Details</h3><ul> <li><p><strong>数据存储</strong></p> <p> 以 JSON 模拟数据表的形式存储于 LocalStorage 中</p> <pre><code> 使用数据库的思想,构建3张表。 cateJson 分类 childCateJson 子分类 taskJson 任务 分类表 cate ---------------------- id* | name | child(FK) ---------------------- 子分类表 childCate -------------------------------- id* | pid(FK) | name | child(FK) -------------------------------- 任务表 task ---------------------------------------------- id* | pid(FK) | finish | name | date | content ---------------------------------------------- </code></pre> </li> <li><p><strong>使用 <code>Sass</code> 重构了 CSS 代码</strong></p> <p> 使用分块、继承等方式,使得代码更加清晰明了。</p> </li> <li><p><strong>响应式布局</strong></p> <p> 针对手机端细节做了很多调整,更符合手机上的视觉交互习惯。</p> </li> <li><p><strong>加入页面切换效果</strong></p> <p> 使用 <code>translate3d()</code>,纯 CSS3 切换动画效果。</p> </li> <li><p><strong>处理了 XSS 防护</strong></p> <p> 对可能造成破坏的字符进行转码。</p> </li> <li><p><strong>性能优化</strong></p> <p> 使用 CDN 处理静态资源 fontAwesome,压缩静态资源等</p> </li> <li><p><strong>模块化</strong></p> <p> 使用 requireJS 模块化 JavaScript 代码。重构 JavaScript 代码。优化之前写的耦合性高的绑定事件,重新绑定事件,降低耦合性。期间根据具体需求重写了事件代理的代码。</p> </li> <li><p><strong>前端工程化</strong></p> <p> 使用 gulp,自动编译 Sass,压缩 CSS 和 JavaScript 代码。并且配置了自动流程。</p> </li> </ul> <hr> <h2 id="其他"><a href="#其他" class="headerlink" title="其他"></a>其他</h2><h3 id="webkit-tap-highlight-color-属性"><a href="#webkit-tap-highlight-color-属性" class="headerlink" title="-webkit-tap-highlight-color 属性"></a><code>-webkit-tap-highlight-color</code> 属性</h3><p>感谢 <a target="_blank" rel="noopener" href="https://github.com/fiona23">fiona</a> 指出。</p> <p>safari移动端点击的时候会闪一下加上 <code>-webkit-tap-highlight-color: transparent;</code> 就不会闪了。</p> <p>参考:</p> <ul> <li><a target="_blank" rel="noopener" href="http://www.css88.com/webkit/-webkit-tap-highlight-color/"><code>-webkit-tap-highlight-color</code> css88</a></li> <li><a target="_blank" rel="noopener" href="http://ued.ctrip.com/webkitcss/prop/tap-highlight-color.html"><code>-webkit-tap-highlight-color</code> 属性</a></li> </ul> <hr> <h3 id="textarea-标签-disabled-颜色"><a href="#textarea-标签-disabled-颜色" class="headerlink" title="textarea 标签 disabled 颜色"></a>textarea 标签 disabled 颜色</h3><ul> <li><p>为什么用 disabled 属性?</p> <p> 因为我发现仅仅使用 readonly 属性,在 IE 下是显示光标的。于是使用 disabled。</p> </li> <li><p>出现的问题</p> <p> 各家浏览器对于 disabled 属性有自己的样式设定,比如 IE 下是灰色的。苹果设备下也是。改变这些样式的方法也不是统一的。如果要兼容 Safari 必须加上</p> </li> </ul> <figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><span class="line">background: #fff;</span><br><span class="line">-webkit-text-fill-color: rgba(0, 0, 0, 1);</span><br><span class="line">-webkit-opacity: 1;</span><br></pre></td></tr></table></figure> <p>于是最终代码如下:</p> <figure class="highlight css"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line"><span class="selector-tag">textarea</span><span class="selector-pseudo">:disabled</span> {</span><br><span class="line"> <span class="attribute">color</span>:<span class="number">#000</span>;</span><br><span class="line"> <span class="attribute">background</span>: <span class="number">#fff</span>;</span><br><span class="line"> -webkit-<span class="selector-tag">text</span>-<span class="attribute">fill</span>-<span class="attribute">color</span>: <span class="built_in">rgba</span>(<span class="number">0</span>, <span class="number">0</span>, <span class="number">0</span>, <span class="number">1</span>);</span><br><span class="line"> -webkit-<span class="attribute">opacity</span>: <span class="number">1</span>;</span><br><span class="line">}</span><br></pre></td></tr></table></figure> <ul> <li>参考:<a target="_blank" rel="noopener" href="http://stackoverflow.com/a/4648315">Disabled input text color 中的评论</a></li> </ul> </div> <div class="article-info article-info-index"> <div class="article-tag tagcloud"> <i class="icon-price-tags icon"></i> <ul class="article-tag-list"> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag article-tag-list-link color3">JavaScript HTML CSS Sass 移动端 XSS AMD requireJS CommonJS 性能优化 WebApp</a> </li> </ul> </div> <div class="article-category tagcloud"> <i class="icon-book icon"></i> <ul class="article-tag-list"> <li class="article-tag-list-item"> <a href="/categories/JavaScript//" class="article-tag-list-link color1">JavaScript</a> </li> </ul> </div> <p class="article-more-link"> <a class="article-more-a" href="/2015/06/17/2015-06-17-web-app/">展开全文 >></a> </p> <div class="clearfix"></div> </div> </div> </article> <aside class="wrap-side-operation"> <div class="mod-side-operation"> <div class="jump-container" id="js-jump-container" style="display:none;"> <a href="javascript:void(0)" class="mod-side-operation__jump-to-top"> <i class="icon-font icon-back"></i> </a> <div id="js-jump-plan-container" class="jump-plan-container" style="top: -11px;"> <i class="icon-font icon-plane jump-plane"></i> </div> </div> </div> </aside> <!-- 目录内容 --> <!-- 目录内容结束 --> <nav id="page-nav"> <a class="extend prev" rel="prev" href="/page/31/">« Prev</a><a class="page-number" href="/">1</a><span class="space">…</span><a class="page-number" href="/page/30/">30</a><a class="page-number" href="/page/31/">31</a><span class="page-number current">32</span><a class="page-number" href="/page/33/">33</a><a class="page-number" href="/page/34/">34</a><a class="extend next" rel="next" href="/page/33/">Next »</a> </nav> </div> </div> </div> <footer id="footer"> <div class="outer"> <div id="footer-info"> <div class="footer-left"> © 2026 liupeng </div> <!--统计start--> <script async src="//busuanzi.ibruce.info/busuanzi/2.3/busuanzi.pure.mini.js"> </script> <span id="busuanzi_container_site_pv"> 本站总访问量<span id="busuanzi_value_site_pv"></span>次 </span> <span id="busuanzi_container_site_uv"> 您是本站的第<span id="busuanzi_value_site_uv"></span>个小伙伴 </span> 本文总阅读量<span id="busuanzi_value_page_pv"></span>次 <!--统计end--> <div class="footer-right"> <a href="http://hexo.io/" target="_blank">Hexo</a> Theme <a href="https://github.com/litten/hexo-theme-yilia" target="_blank">Yilia</a> by Litten </div> <!--运行时间--> </div> </div> </footer> </div> <script> var yiliaConfig = { mathjax: false, isHome: true, isPost: false, isArchive: false, isTag: false, isCategory: false, open_in_new: false, toc_hide_index: true, root: "/", innerArchive: true, showTags: false } </script> <script>!function(t){function n(e){if(r[e])return r[e].exports;var i=r[e]={exports:{},id:e,loaded:!1};return t[e].call(i.exports,i,i.exports,n),i.loaded=!0,i.exports}var r={};n.m=t,n.c=r,n.p="./",n(0)}([function(t,n,r){r(195),t.exports=r(191)},function(t,n,r){var e=r(3),i=r(52),o=r(27),u=r(28),c=r(53),f="prototype",a=function(t,n,r){var s,l,h,v,p=t&a.F,d=t&a.G,y=t&a.S,g=t&a.P,b=t&a.B,m=d?e:y?e[n]||(e[n]={}):(e[n]||{})[f],x=d?i:i[n]||(i[n]={}),w=x[f]||(x[f]={});d&&(r=n);for(s in r)l=!p&&m&&void 0!==m[s],h=(l?m:r)[s],v=b&&l?c(h,e):g&&"function"==typeof h?c(Function.call,h):h,m&&u(m,s,h,t&a.U),x[s]!=h&&o(x,s,v),g&&w[s]!=h&&(w[s]=h)};e.core=i,a.F=1,a.G=2,a.S=4,a.P=8,a.B=16,a.W=32,a.U=64,a.R=128,t.exports=a},function(t,n,r){var e=r(6);t.exports=function(t){if(!e(t))throw TypeError(t+" is not an object!");return t}},function(t,n){var r=t.exports="undefined"!=typeof window&&window.Math==Math?window:"undefined"!=typeof self&&self.Math==Math?self:Function("return this")();"number"==typeof __g&&(__g=r)},function(t,n){t.exports=function(t){try{return!!t()}catch(t){return!0}}},function(t,n){var r=t.exports="undefined"!=typeof window&&window.Math==Math?window:"undefined"!=typeof self&&self.Math==Math?self:Function("return this")();"number"==typeof __g&&(__g=r)},function(t,n){t.exports=function(t){return"object"==typeof t?null!==t:"function"==typeof t}},function(t,n,r){var e=r(126)("wks"),i=r(76),o=r(3).Symbol,u="function"==typeof o;(t.exports=function(t){return e[t]||(e[t]=u&&o[t]||(u?o:i)("Symbol."+t))}).store=e},function(t,n){var r={}.hasOwnProperty;t.exports=function(t,n){return r.call(t,n)}},function(t,n,r){var e=r(94),i=r(33);t.exports=function(t){return e(i(t))}},function(t,n,r){t.exports=!r(4)(function(){return 7!=Object.defineProperty({},"a",{get:function(){return 7}}).a})},function(t,n,r){var e=r(2),i=r(167),o=r(50),u=Object.defineProperty;n.f=r(10)?Object.defineProperty:function(t,n,r){if(e(t),n=o(n,!0),e(r),i)try{return u(t,n,r)}catch(t){}if("get"in r||"set"in r)throw TypeError("Accessors not supported!");return"value"in r&&(t[n]=r.value),t}},function(t,n,r){t.exports=!r(18)(function(){return 7!=Object.defineProperty({},"a",{get:function(){return 7}}).a})},function(t,n,r){var e=r(14),i=r(22);t.exports=r(12)?function(t,n,r){return e.f(t,n,i(1,r))}:function(t,n,r){return t[n]=r,t}},function(t,n,r){var e=r(20),i=r(58),o=r(42),u=Object.defineProperty;n.f=r(12)?Object.defineProperty:function(t,n,r){if(e(t),n=o(n,!0),e(r),i)try{return u(t,n,r)}catch(t){}if("get"in r||"set"in r)throw TypeError("Accessors not supported!");return"value"in r&&(t[n]=r.value),t}},function(t,n,r){var e=r(40)("wks"),i=r(23),o=r(5).Symbol,u="function"==typeof o;(t.exports=function(t){return e[t]||(e[t]=u&&o[t]||(u?o:i)("Symbol."+t))}).store=e},function(t,n,r){var e=r(67),i=Math.min;t.exports=function(t){return t>0?i(e(t),9007199254740991):0}},function(t,n,r){var e=r(46);t.exports=function(t){return Object(e(t))}},function(t,n){t.exports=function(t){try{return!!t()}catch(t){return!0}}},function(t,n,r){var e=r(63),i=r(34);t.exports=Object.keys||function(t){return e(t,i)}},function(t,n,r){var e=r(21);t.exports=function(t){if(!e(t))throw TypeError(t+" is not an object!");return t}},function(t,n){t.exports=function(t){return"object"==typeof t?null!==t:"function"==typeof t}},function(t,n){t.exports=function(t,n){return{enumerable:!(1&t),configurable:!(2&t),writable:!(4&t),value:n}}},function(t,n){var r=0,e=Math.random();t.exports=function(t){return"Symbol(".concat(void 0===t?"":t,")_",(++r+e).toString(36))}},function(t,n){var r={}.hasOwnProperty;t.exports=function(t,n){return r.call(t,n)}},function(t,n){var r=t.exports={version:"2.4.0"};"number"==typeof __e&&(__e=r)},function(t,n){t.exports=function(t){if("function"!=typeof t)throw TypeError(t+" is not a function!");return t}},function(t,n,r){var e=r(11),i=r(66);t.exports=r(10)?function(t,n,r){return e.f(t,n,i(1,r))}:function(t,n,r){return t[n]=r,t}},function(t,n,r){var e=r(3),i=r(27),o=r(24),u=r(76)("src"),c="toString",f=Function[c],a=(""+f).split(c);r(52).inspectSource=function(t){return f.call(t)},(t.exports=function(t,n,r,c){var f="function"==typeof r;f&&(o(r,"name")||i(r,"name",n)),t[n]!==r&&(f&&(o(r,u)||i(r,u,t[n]?""+t[n]:a.join(String(n)))),t===e?t[n]=r:c?t[n]?t[n]=r:i(t,n,r):(delete t[n],i(t,n,r)))})(Function.prototype,c,function(){return"function"==typeof this&&this[u]||f.call(this)})},function(t,n,r){var e=r(1),i=r(4),o=r(46),u=function(t,n,r,e){var i=String(o(t)),u="<"+n;return""!==r&&(u+=" "+r+'="'+String(e).replace(/"/g,""")+'"'),u+">"+i+"</"+n+">"};t.exports=function(t,n){var r={};r[t]=n(u),e(e.P+e.F*i(function(){var n=""[t]('"');return n!==n.toLowerCase()||n.split('"').length>3}),"String",r)}},function(t,n,r){var e=r(115),i=r(46);t.exports=function(t){return e(i(t))}},function(t,n,r){var e=r(116),i=r(66),o=r(30),u=r(50),c=r(24),f=r(167),a=Object.getOwnPropertyDescriptor;n.f=r(10)?a:function(t,n){if(t=o(t),n=u(n,!0),f)try{return a(t,n)}catch(t){}if(c(t,n))return i(!e.f.call(t,n),t[n])}},function(t,n,r){var e=r(24),i=r(17),o=r(145)("IE_PROTO"),u=Object.prototype;t.exports=Object.getPrototypeOf||function(t){return t=i(t),e(t,o)?t[o]:"function"==typeof t.constructor&&t instanceof t.constructor?t.constructor.prototype:t instanceof Object?u:null}},function(t,n){t.exports=function(t){if(void 0==t)throw TypeError("Can't call method on "+t);return t}},function(t,n){t.exports="constructor,hasOwnProperty,isPrototypeOf,propertyIsEnumerable,toLocaleString,toString,valueOf".split(",")},function(t,n){t.exports={}},function(t,n){t.exports=!0},function(t,n){n.f={}.propertyIsEnumerable},function(t,n,r){var e=r(14).f,i=r(8),o=r(15)("toStringTag");t.exports=function(t,n,r){t&&!i(t=r?t:t.prototype,o)&&e(t,o,{configurable:!0,value:n})}},function(t,n,r){var e=r(40)("keys"),i=r(23);t.exports=function(t){return e[t]||(e[t]=i(t))}},function(t,n,r){var e=r(5),i="__core-js_shared__",o=e[i]||(e[i]={});t.exports=function(t){return o[t]||(o[t]={})}},function(t,n){var r=Math.ceil,e=Math.floor;t.exports=function(t){return isNaN(t=+t)?0:(t>0?e:r)(t)}},function(t,n,r){var e=r(21);t.exports=function(t,n){if(!e(t))return t;var r,i;if(n&&"function"==typeof(r=t.toString)&&!e(i=r.call(t)))return i;if("function"==typeof(r=t.valueOf)&&!e(i=r.call(t)))return i;if(!n&&"function"==typeof(r=t.toString)&&!e(i=r.call(t)))return i;throw TypeError("Can't convert object to primitive value")}},function(t,n,r){var e=r(5),i=r(25),o=r(36),u=r(44),c=r(14).f;t.exports=function(t){var n=i.Symbol||(i.Symbol=o?{}:e.Symbol||{});"_"==t.charAt(0)||t in n||c(n,t,{value:u.f(t)})}},function(t,n,r){n.f=r(15)},function(t,n){var r={}.toString;t.exports=function(t){return r.call(t).slice(8,-1)}},function(t,n){t.exports=function(t){if(void 0==t)throw TypeError("Can't call method on "+t);return t}},function(t,n,r){var e=r(4);t.exports=function(t,n){return!!t&&e(function(){n?t.call(null,function(){},1):t.call(null)})}},function(t,n,r){var e=r(53),i=r(115),o=r(17),u=r(16),c=r(203);t.exports=function(t,n){var r=1==t,f=2==t,a=3==t,s=4==t,l=6==t,h=5==t||l,v=n||c;return function(n,c,p){for(var d,y,g=o(n),b=i(g),m=e(c,p,3),x=u(b.length),w=0,S=r?v(n,x):f?v(n,0):void 0;x>w;w++)if((h||w in b)&&(d=b[w],y=m(d,w,g),t))if(r)S[w]=y;else if(y)switch(t){case 3:return!0;case 5:return d;case 6:return w;case 2:S.push(d)}else if(s)return!1;return l?-1:a||s?s:S}}},function(t,n,r){var e=r(1),i=r(52),o=r(4);t.exports=function(t,n){var r=(i.Object||{})[t]||Object[t],u={};u[t]=n(r),e(e.S+e.F*o(function(){r(1)}),"Object",u)}},function(t,n,r){var e=r(6);t.exports=function(t,n){if(!e(t))return t;var r,i;if(n&&"function"==typeof(r=t.toString)&&!e(i=r.call(t)))return i;if("function"==typeof(r=t.valueOf)&&!e(i=r.call(t)))return i;if(!n&&"function"==typeof(r=t.toString)&&!e(i=r.call(t)))return i;throw TypeError("Can't convert object to primitive value")}},function(t,n,r){var e=r(5),i=r(25),o=r(91),u=r(13),c="prototype",f=function(t,n,r){var a,s,l,h=t&f.F,v=t&f.G,p=t&f.S,d=t&f.P,y=t&f.B,g=t&f.W,b=v?i:i[n]||(i[n]={}),m=b[c],x=v?e:p?e[n]:(e[n]||{})[c];v&&(r=n);for(a in r)(s=!h&&x&&void 0!==x[a])&&a in b||(l=s?x[a]:r[a],b[a]=v&&"function"!=typeof x[a]?r[a]:y&&s?o(l,e):g&&x[a]==l?function(t){var n=function(n,r,e){if(this instanceof t){switch(arguments.length){case 0:return new t;case 1:return new t(n);case 2:return new t(n,r)}return new t(n,r,e)}return t.apply(this,arguments)};return n[c]=t[c],n}(l):d&&"function"==typeof l?o(Function.call,l):l,d&&((b.virtual||(b.virtual={}))[a]=l,t&f.R&&m&&!m[a]&&u(m,a,l)))};f.F=1,f.G=2,f.S=4,f.P=8,f.B=16,f.W=32,f.U=64,f.R=128,t.exports=f},function(t,n){var r=t.exports={version:"2.4.0"};"number"==typeof __e&&(__e=r)},function(t,n,r){var e=r(26);t.exports=function(t,n,r){if(e(t),void 0===n)return t;switch(r){case 1:return function(r){return t.call(n,r)};case 2:return function(r,e){return t.call(n,r,e)};case 3:return function(r,e,i){return t.call(n,r,e,i)}}return function(){return t.apply(n,arguments)}}},function(t,n,r){var e=r(183),i=r(1),o=r(126)("metadata"),u=o.store||(o.store=new(r(186))),c=function(t,n,r){var i=u.get(t);if(!i){if(!r)return;u.set(t,i=new e)}var o=i.get(n);if(!o){if(!r)return;i.set(n,o=new e)}return o},f=function(t,n,r){var e=c(n,r,!1);return void 0!==e&&e.has(t)},a=function(t,n,r){var e=c(n,r,!1);return void 0===e?void 0:e.get(t)},s=function(t,n,r,e){c(r,e,!0).set(t,n)},l=function(t,n){var r=c(t,n,!1),e=[];return r&&r.forEach(function(t,n){e.push(n)}),e},h=function(t){return void 0===t||"symbol"==typeof t?t:String(t)},v=function(t){i(i.S,"Reflect",t)};t.exports={store:u,map:c,has:f,get:a,set:s,keys:l,key:h,exp:v}},function(t,n,r){"use strict";if(r(10)){var e=r(69),i=r(3),o=r(4),u=r(1),c=r(127),f=r(152),a=r(53),s=r(68),l=r(66),h=r(27),v=r(73),p=r(67),d=r(16),y=r(75),g=r(50),b=r(24),m=r(180),x=r(114),w=r(6),S=r(17),_=r(137),O=r(70),E=r(32),P=r(71).f,j=r(154),F=r(76),M=r(7),A=r(48),N=r(117),T=r(146),I=r(155),k=r(80),L=r(123),R=r(74),C=r(130),D=r(160),U=r(11),W=r(31),G=U.f,B=W.f,V=i.RangeError,z=i.TypeError,q=i.Uint8Array,K="ArrayBuffer",J="Shared"+K,Y="BYTES_PER_ELEMENT",H="prototype",$=Array[H],X=f.ArrayBuffer,Q=f.DataView,Z=A(0),tt=A(2),nt=A(3),rt=A(4),et=A(5),it=A(6),ot=N(!0),ut=N(!1),ct=I.values,ft=I.keys,at=I.entries,st=$.lastIndexOf,lt=$.reduce,ht=$.reduceRight,vt=$.join,pt=$.sort,dt=$.slice,yt=$.toString,gt=$.toLocaleString,bt=M("iterator"),mt=M("toStringTag"),xt=F("typed_constructor"),wt=F("def_constructor"),St=c.CONSTR,_t=c.TYPED,Ot=c.VIEW,Et="Wrong length!",Pt=A(1,function(t,n){return Tt(T(t,t[wt]),n)}),jt=o(function(){return 1===new q(new Uint16Array([1]).buffer)[0]}),Ft=!!q&&!!q[H].set&&o(function(){new q(1).set({})}),Mt=function(t,n){if(void 0===t)throw z(Et);var r=+t,e=d(t);if(n&&!m(r,e))throw V(Et);return e},At=function(t,n){var r=p(t);if(r<0||r%n)throw V("Wrong offset!");return r},Nt=function(t){if(w(t)&&_t in t)return t;throw z(t+" is not a typed array!")},Tt=function(t,n){if(!(w(t)&&xt in t))throw z("It is not a typed array constructor!");return new t(n)},It=function(t,n){return kt(T(t,t[wt]),n)},kt=function(t,n){for(var r=0,e=n.length,i=Tt(t,e);e>r;)i[r]=n[r++];return i},Lt=function(t,n,r){G(t,n,{get:function(){return this._d[r]}})},Rt=function(t){var n,r,e,i,o,u,c=S(t),f=arguments.length,s=f>1?arguments[1]:void 0,l=void 0!==s,h=j(c);if(void 0!=h&&!_(h)){for(u=h.call(c),e=[],n=0;!(o=u.next()).done;n++)e.push(o.value);c=e}for(l&&f>2&&(s=a(s,arguments[2],2)),n=0,r=d(c.length),i=Tt(this,r);r>n;n++)i[n]=l?s(c[n],n):c[n];return i},Ct=function(){for(var t=0,n=arguments.length,r=Tt(this,n);n>t;)r[t]=arguments[t++];return r},Dt=!!q&&o(function(){gt.call(new q(1))}),Ut=function(){return gt.apply(Dt?dt.call(Nt(this)):Nt(this),arguments)},Wt={copyWithin:function(t,n){return D.call(Nt(this),t,n,arguments.length>2?arguments[2]:void 0)},every:function(t){return rt(Nt(this),t,arguments.length>1?arguments[1]:void 0)},fill:function(t){return C.apply(Nt(this),arguments)},filter:function(t){return It(this,tt(Nt(this),t,arguments.length>1?arguments[1]:void 0))},find:function(t){return et(Nt(this),t,arguments.length>1?arguments[1]:void 0)},findIndex:function(t){return it(Nt(this),t,arguments.length>1?arguments[1]:void 0)},forEach:function(t){Z(Nt(this),t,arguments.length>1?arguments[1]:void 0)},indexOf:function(t){return ut(Nt(this),t,arguments.length>1?arguments[1]:void 0)},includes:function(t){return ot(Nt(this),t,arguments.length>1?arguments[1]:void 0)},join:function(t){return vt.apply(Nt(this),arguments)},lastIndexOf:function(t){return st.apply(Nt(this),arguments)},map:function(t){return Pt(Nt(this),t,arguments.length>1?arguments[1]:void 0)},reduce:function(t){return lt.apply(Nt(this),arguments)},reduceRight:function(t){return ht.apply(Nt(this),arguments)},reverse:function(){for(var t,n=this,r=Nt(n).length,e=Math.floor(r/2),i=0;i<e;)t=n[i],n[i++]=n[--r],n[r]=t;return n},some:function(t){return nt(Nt(this),t,arguments.length>1?arguments[1]:void 0)},sort:function(t){return pt.call(Nt(this),t)},subarray:function(t,n){var r=Nt(this),e=r.length,i=y(t,e);return new(T(r,r[wt]))(r.buffer,r.byteOffset+i*r.BYTES_PER_ELEMENT,d((void 0===n?e:y(n,e))-i))}},Gt=function(t,n){return It(this,dt.call(Nt(this),t,n))},Bt=function(t){Nt(this);var n=At(arguments[1],1),r=this.length,e=S(t),i=d(e.length),o=0;if(i+n>r)throw V(Et);for(;o<i;)this[n+o]=e[o++]},Vt={entries:function(){return at.call(Nt(this))},keys:function(){return ft.call(Nt(this))},values:function(){return ct.call(Nt(this))}},zt=function(t,n){return w(t)&&t[_t]&&"symbol"!=typeof n&&n in t&&String(+n)==String(n)},qt=function(t,n){return zt(t,n=g(n,!0))?l(2,t[n]):B(t,n)},Kt=function(t,n,r){return!(zt(t,n=g(n,!0))&&w(r)&&b(r,"value"))||b(r,"get")||b(r,"set")||r.configurable||b(r,"writable")&&!r.writable||b(r,"enumerable")&&!r.enumerable?G(t,n,r):(t[n]=r.value,t)};St||(W.f=qt,U.f=Kt),u(u.S+u.F*!St,"Object",{getOwnPropertyDescriptor:qt,defineProperty:Kt}),o(function(){yt.call({})})&&(yt=gt=function(){return vt.call(this)});var Jt=v({},Wt);v(Jt,Vt),h(Jt,bt,Vt.values),v(Jt,{slice:Gt,set:Bt,constructor:function(){},toString:yt,toLocaleString:Ut}),Lt(Jt,"buffer","b"),Lt(Jt,"byteOffset","o"),Lt(Jt,"byteLength","l"),Lt(Jt,"length","e"),G(Jt,mt,{get:function(){return this[_t]}}),t.exports=function(t,n,r,f){f=!!f;var a=t+(f?"Clamped":"")+"Array",l="Uint8Array"!=a,v="get"+t,p="set"+t,y=i[a],g=y||{},b=y&&E(y),m=!y||!c.ABV,S={},_=y&&y[H],j=function(t,r){var e=t._d;return e.v[v](r*n+e.o,jt)},F=function(t,r,e){var i=t._d;f&&(e=(e=Math.round(e))<0?0:e>255?255:255&e),i.v[p](r*n+i.o,e,jt)},M=function(t,n){G(t,n,{get:function(){return j(this,n)},set:function(t){return F(this,n,t)},enumerable:!0})};m?(y=r(function(t,r,e,i){s(t,y,a,"_d");var o,u,c,f,l=0,v=0;if(w(r)){if(!(r instanceof X||(f=x(r))==K||f==J))return _t in r?kt(y,r):Rt.call(y,r);o=r,v=At(e,n);var p=r.byteLength;if(void 0===i){if(p%n)throw V(Et);if((u=p-v)<0)throw V(Et)}else if((u=d(i)*n)+v>p)throw V(Et);c=u/n}else c=Mt(r,!0),u=c*n,o=new X(u);for(h(t,"_d",{b:o,o:v,l:u,e:c,v:new Q(o)});l<c;)M(t,l++)}),_=y[H]=O(Jt),h(_,"constructor",y)):L(function(t){new y(null),new y(t)},!0)||(y=r(function(t,r,e,i){s(t,y,a);var o;return w(r)?r instanceof X||(o=x(r))==K||o==J?void 0!==i?new g(r,At(e,n),i):void 0!==e?new g(r,At(e,n)):new g(r):_t in r?kt(y,r):Rt.call(y,r):new g(Mt(r,l))}),Z(b!==Function.prototype?P(g).concat(P(b)):P(g),function(t){t in y||h(y,t,g[t])}),y[H]=_,e||(_.constructor=y));var A=_[bt],N=!!A&&("values"==A.name||void 0==A.name),T=Vt.values;h(y,xt,!0),h(_,_t,a),h(_,Ot,!0),h(_,wt,y),(f?new y(1)[mt]==a:mt in _)||G(_,mt,{get:function(){return a}}),S[a]=y,u(u.G+u.W+u.F*(y!=g),S),u(u.S,a,{BYTES_PER_ELEMENT:n,from:Rt,of:Ct}),Y in _||h(_,Y,n),u(u.P,a,Wt),R(a),u(u.P+u.F*Ft,a,{set:Bt}),u(u.P+u.F*!N,a,Vt),u(u.P+u.F*(_.toString!=yt),a,{toString:yt}),u(u.P+u.F*o(function(){new y(1).slice()}),a,{slice:Gt}),u(u.P+u.F*(o(function(){return[1,2].toLocaleString()!=new y([1,2]).toLocaleString()})||!o(function(){_.toLocaleString.call([1,2])})),a,{toLocaleString:Ut}),k[a]=N?A:T,e||N||h(_,bt,T)}}else t.exports=function(){}},function(t,n){var r={}.toString;t.exports=function(t){return r.call(t).slice(8,-1)}},function(t,n,r){var e=r(21),i=r(5).document,o=e(i)&&e(i.createElement);t.exports=function(t){return o?i.createElement(t):{}}},function(t,n,r){t.exports=!r(12)&&!r(18)(function(){return 7!=Object.defineProperty(r(57)("div"),"a",{get:function(){return 7}}).a})},function(t,n,r){"use strict";var e=r(36),i=r(51),o=r(64),u=r(13),c=r(8),f=r(35),a=r(96),s=r(38),l=r(103),h=r(15)("iterator"),v=!([].keys&&"next"in[].keys()),p="keys",d="values",y=function(){return this};t.exports=function(t,n,r,g,b,m,x){a(r,n,g);var w,S,_,O=function(t){if(!v&&t in F)return F[t];switch(t){case p:case d:return function(){return new r(this,t)}}return function(){return new r(this,t)}},E=n+" Iterator",P=b==d,j=!1,F=t.prototype,M=F[h]||F["@@iterator"]||b&&F[b],A=M||O(b),N=b?P?O("entries"):A:void 0,T="Array"==n?F.entries||M:M;if(T&&(_=l(T.call(new t)))!==Object.prototype&&(s(_,E,!0),e||c(_,h)||u(_,h,y)),P&&M&&M.name!==d&&(j=!0,A=function(){return M.call(this)}),e&&!x||!v&&!j&&F[h]||u(F,h,A),f[n]=A,f[E]=y,b)if(w={values:P?A:O(d),keys:m?A:O(p),entries:N},x)for(S in w)S in F||o(F,S,w[S]);else i(i.P+i.F*(v||j),n,w);return w}},function(t,n,r){var e=r(20),i=r(100),o=r(34),u=r(39)("IE_PROTO"),c=function(){},f="prototype",a=function(){var t,n=r(57)("iframe"),e=o.length;for(n.style.display="none",r(93).appendChild(n),n.src="javascript:",t=n.contentWindow.document,t.open(),t.write("<script>document.F=Object<\/script>"),t.close(),a=t.F;e--;)delete a[f][o[e]];return a()};t.exports=Object.create||function(t,n){var r;return null!==t?(c[f]=e(t),r=new c,c[f]=null,r[u]=t):r=a(),void 0===n?r:i(r,n)}},function(t,n,r){var e=r(63),i=r(34).concat("length","prototype");n.f=Object.getOwnPropertyNames||function(t){return e(t,i)}},function(t,n){n.f=Object.getOwnPropertySymbols},function(t,n,r){var e=r(8),i=r(9),o=r(90)(!1),u=r(39)("IE_PROTO");t.exports=function(t,n){var r,c=i(t),f=0,a=[];for(r in c)r!=u&&e(c,r)&&a.push(r);for(;n.length>f;)e(c,r=n[f++])&&(~o(a,r)||a.push(r));return a}},function(t,n,r){t.exports=r(13)},function(t,n,r){var e=r(76)("meta"),i=r(6),o=r(24),u=r(11).f,c=0,f=Object.isExtensible||function(){return!0},a=!r(4)(function(){return f(Object.preventExtensions({}))}),s=function(t){u(t,e,{value:{i:"O"+ ++c,w:{}}})},l=function(t,n){if(!i(t))return"symbol"==typeof t?t:("string"==typeof t?"S":"P")+t;if(!o(t,e)){if(!f(t))return"F";if(!n)return"E";s(t)}return t[e].i},h=function(t,n){if(!o(t,e)){if(!f(t))return!0;if(!n)return!1;s(t)}return t[e].w},v=function(t){return a&&p.NEED&&f(t)&&!o(t,e)&&s(t),t},p=t.exports={KEY:e,NEED:!1,fastKey:l,getWeak:h,onFreeze:v}},function(t,n){t.exports=function(t,n){return{enumerable:!(1&t),configurable:!(2&t),writable:!(4&t),value:n}}},function(t,n){var r=Math.ceil,e=Math.floor;t.exports=function(t){return isNaN(t=+t)?0:(t>0?e:r)(t)}},function(t,n){t.exports=function(t,n,r,e){if(!(t instanceof n)||void 0!==e&&e in t)throw TypeError(r+": incorrect invocation!");return t}},function(t,n){t.exports=!1},function(t,n,r){var e=r(2),i=r(173),o=r(133),u=r(145)("IE_PROTO"),c=function(){},f="prototype",a=function(){var t,n=r(132)("iframe"),e=o.length;for(n.style.display="none",r(135).appendChild(n),n.src="javascript:",t=n.contentWindow.document,t.open(),t.write("<script>document.F=Object<\/script>"),t.close(),a=t.F;e--;)delete a[f][o[e]];return a()};t.exports=Object.create||function(t,n){var r;return null!==t?(c[f]=e(t),r=new c,c[f]=null,r[u]=t):r=a(),void 0===n?r:i(r,n)}},function(t,n,r){var e=r(175),i=r(133).concat("length","prototype");n.f=Object.getOwnPropertyNames||function(t){return e(t,i)}},function(t,n,r){var e=r(175),i=r(133);t.exports=Object.keys||function(t){return e(t,i)}},function(t,n,r){var e=r(28);t.exports=function(t,n,r){for(var i in n)e(t,i,n[i],r);return t}},function(t,n,r){"use strict";var e=r(3),i=r(11),o=r(10),u=r(7)("species");t.exports=function(t){var n=e[t];o&&n&&!n[u]&&i.f(n,u,{configurable:!0,get:function(){return this}})}},function(t,n,r){var e=r(67),i=Math.max,o=Math.min;t.exports=function(t,n){return t=e(t),t<0?i(t+n,0):o(t,n)}},function(t,n){var r=0,e=Math.random();t.exports=function(t){return"Symbol(".concat(void 0===t?"":t,")_",(++r+e).toString(36))}},function(t,n,r){var e=r(33);t.exports=function(t){return Object(e(t))}},function(t,n,r){var e=r(7)("unscopables"),i=Array.prototype;void 0==i[e]&&r(27)(i,e,{}),t.exports=function(t){i[e][t]=!0}},function(t,n,r){var e=r(53),i=r(169),o=r(137),u=r(2),c=r(16),f=r(154),a={},s={},n=t.exports=function(t,n,r,l,h){var v,p,d,y,g=h?function(){return t}:f(t),b=e(r,l,n?2:1),m=0;if("function"!=typeof g)throw TypeError(t+" is not iterable!");if(o(g)){for(v=c(t.length);v>m;m++)if((y=n?b(u(p=t[m])[0],p[1]):b(t[m]))===a||y===s)return y}else for(d=g.call(t);!(p=d.next()).done;)if((y=i(d,b,p.value,n))===a||y===s)return y};n.BREAK=a,n.RETURN=s},function(t,n){t.exports={}},function(t,n,r){var e=r(11).f,i=r(24),o=r(7)("toStringTag");t.exports=function(t,n,r){t&&!i(t=r?t:t.prototype,o)&&e(t,o,{configurable:!0,value:n})}},function(t,n,r){var e=r(1),i=r(46),o=r(4),u=r(150),c="["+u+"]",f=" ",a=RegExp("^"+c+c+"*"),s=RegExp(c+c+"*$"),l=function(t,n,r){var i={},c=o(function(){return!!u[t]()||f[t]()!=f}),a=i[t]=c?n(h):u[t];r&&(i[r]=a),e(e.P+e.F*c,"String",i)},h=l.trim=function(t,n){return t=String(i(t)),1&n&&(t=t.replace(a,"")),2&n&&(t=t.replace(s,"")),t};t.exports=l},function(t,n,r){t.exports={default:r(86),__esModule:!0}},function(t,n,r){t.exports={default:r(87),__esModule:!0}},function(t,n,r){"use strict";function e(t){return t&&t.__esModule?t:{default:t}}n.__esModule=!0;var i=r(84),o=e(i),u=r(83),c=e(u),f="function"==typeof c.default&&"symbol"==typeof o.default?function(t){return typeof t}:function(t){return t&&"function"==typeof c.default&&t.constructor===c.default&&t!==c.default.prototype?"symbol":typeof t};n.default="function"==typeof c.default&&"symbol"===f(o.default)?function(t){return void 0===t?"undefined":f(t)}:function(t){return t&&"function"==typeof c.default&&t.constructor===c.default&&t!==c.default.prototype?"symbol":void 0===t?"undefined":f(t)}},function(t,n,r){r(110),r(108),r(111),r(112),t.exports=r(25).Symbol},function(t,n,r){r(109),r(113),t.exports=r(44).f("iterator")},function(t,n){t.exports=function(t){if("function"!=typeof t)throw TypeError(t+" is not a function!");return t}},function(t,n){t.exports=function(){}},function(t,n,r){var e=r(9),i=r(106),o=r(105);t.exports=function(t){return function(n,r,u){var c,f=e(n),a=i(f.length),s=o(u,a);if(t&&r!=r){for(;a>s;)if((c=f[s++])!=c)return!0}else for(;a>s;s++)if((t||s in f)&&f[s]===r)return t||s||0;return!t&&-1}}},function(t,n,r){var e=r(88);t.exports=function(t,n,r){if(e(t),void 0===n)return t;switch(r){case 1:return function(r){return t.call(n,r)};case 2:return function(r,e){return t.call(n,r,e)};case 3:return function(r,e,i){return t.call(n,r,e,i)}}return function(){return t.apply(n,arguments)}}},function(t,n,r){var e=r(19),i=r(62),o=r(37);t.exports=function(t){var n=e(t),r=i.f;if(r)for(var u,c=r(t),f=o.f,a=0;c.length>a;)f.call(t,u=c[a++])&&n.push(u);return n}},function(t,n,r){t.exports=r(5).document&&document.documentElement},function(t,n,r){var e=r(56);t.exports=Object("z").propertyIsEnumerable(0)?Object:function(t){return"String"==e(t)?t.split(""):Object(t)}},function(t,n,r){var e=r(56);t.exports=Array.isArray||function(t){return"Array"==e(t)}},function(t,n,r){"use strict";var e=r(60),i=r(22),o=r(38),u={};r(13)(u,r(15)("iterator"),function(){return this}),t.exports=function(t,n,r){t.prototype=e(u,{next:i(1,r)}),o(t,n+" Iterator")}},function(t,n){t.exports=function(t,n){return{value:n,done:!!t}}},function(t,n,r){var e=r(19),i=r(9);t.exports=function(t,n){for(var r,o=i(t),u=e(o),c=u.length,f=0;c>f;)if(o[r=u[f++]]===n)return r}},function(t,n,r){var e=r(23)("meta"),i=r(21),o=r(8),u=r(14).f,c=0,f=Object.isExtensible||function(){return!0},a=!r(18)(function(){return f(Object.preventExtensions({}))}),s=function(t){u(t,e,{value:{i:"O"+ ++c,w:{}}})},l=function(t,n){if(!i(t))return"symbol"==typeof t?t:("string"==typeof t?"S":"P")+t;if(!o(t,e)){if(!f(t))return"F";if(!n)return"E";s(t)}return t[e].i},h=function(t,n){if(!o(t,e)){if(!f(t))return!0;if(!n)return!1;s(t)}return t[e].w},v=function(t){return a&&p.NEED&&f(t)&&!o(t,e)&&s(t),t},p=t.exports={KEY:e,NEED:!1,fastKey:l,getWeak:h,onFreeze:v}},function(t,n,r){var e=r(14),i=r(20),o=r(19);t.exports=r(12)?Object.defineProperties:function(t,n){i(t);for(var r,u=o(n),c=u.length,f=0;c>f;)e.f(t,r=u[f++],n[r]);return t}},function(t,n,r){var e=r(37),i=r(22),o=r(9),u=r(42),c=r(8),f=r(58),a=Object.getOwnPropertyDescriptor;n.f=r(12)?a:function(t,n){if(t=o(t),n=u(n,!0),f)try{return a(t,n)}catch(t){}if(c(t,n))return i(!e.f.call(t,n),t[n])}},function(t,n,r){var e=r(9),i=r(61).f,o={}.toString,u="object"==typeof window&&window&&Object.getOwnPropertyNames?Object.getOwnPropertyNames(window):[],c=function(t){try{return i(t)}catch(t){return u.slice()}};t.exports.f=function(t){return u&&"[object Window]"==o.call(t)?c(t):i(e(t))}},function(t,n,r){var e=r(8),i=r(77),o=r(39)("IE_PROTO"),u=Object.prototype;t.exports=Object.getPrototypeOf||function(t){return t=i(t),e(t,o)?t[o]:"function"==typeof t.constructor&&t instanceof t.constructor?t.constructor.prototype:t instanceof Object?u:null}},function(t,n,r){var e=r(41),i=r(33);t.exports=function(t){return function(n,r){var o,u,c=String(i(n)),f=e(r),a=c.length;return f<0||f>=a?t?"":void 0:(o=c.charCodeAt(f),o<55296||o>56319||f+1===a||(u=c.charCodeAt(f+1))<56320||u>57343?t?c.charAt(f):o:t?c.slice(f,f+2):u-56320+(o-55296<<10)+65536)}}},function(t,n,r){var e=r(41),i=Math.max,o=Math.min;t.exports=function(t,n){return t=e(t),t<0?i(t+n,0):o(t,n)}},function(t,n,r){var e=r(41),i=Math.min;t.exports=function(t){return t>0?i(e(t),9007199254740991):0}},function(t,n,r){"use strict";var e=r(89),i=r(97),o=r(35),u=r(9);t.exports=r(59)(Array,"Array",function(t,n){this._t=u(t),this._i=0,this._k=n},function(){var t=this._t,n=this._k,r=this._i++;return!t||r>=t.length?(this._t=void 0,i(1)):"keys"==n?i(0,r):"values"==n?i(0,t[r]):i(0,[r,t[r]])},"values"),o.Arguments=o.Array,e("keys"),e("values"),e("entries")},function(t,n){},function(t,n,r){"use strict";var e=r(104)(!0);r(59)(String,"String",function(t){this._t=String(t),this._i=0},function(){var t,n=this._t,r=this._i;return r>=n.length?{value:void 0,done:!0}:(t=e(n,r),this._i+=t.length,{value:t,done:!1})})},function(t,n,r){"use strict";var e=r(5),i=r(8),o=r(12),u=r(51),c=r(64),f=r(99).KEY,a=r(18),s=r(40),l=r(38),h=r(23),v=r(15),p=r(44),d=r(43),y=r(98),g=r(92),b=r(95),m=r(20),x=r(9),w=r(42),S=r(22),_=r(60),O=r(102),E=r(101),P=r(14),j=r(19),F=E.f,M=P.f,A=O.f,N=e.Symbol,T=e.JSON,I=T&&T.stringify,k="prototype",L=v("_hidden"),R=v("toPrimitive"),C={}.propertyIsEnumerable,D=s("symbol-registry"),U=s("symbols"),W=s("op-symbols"),G=Object[k],B="function"==typeof N,V=e.QObject,z=!V||!V[k]||!V[k].findChild,q=o&&a(function(){return 7!=_(M({},"a",{get:function(){return M(this,"a",{value:7}).a}})).a})?function(t,n,r){var e=F(G,n);e&&delete G[n],M(t,n,r),e&&t!==G&&M(G,n,e)}:M,K=function(t){var n=U[t]=_(N[k]);return n._k=t,n},J=B&&"symbol"==typeof N.iterator?function(t){return"symbol"==typeof t}:function(t){return t instanceof N},Y=function(t,n,r){return t===G&&Y(W,n,r),m(t),n=w(n,!0),m(r),i(U,n)?(r.enumerable?(i(t,L)&&t[L][n]&&(t[L][n]=!1),r=_(r,{enumerable:S(0,!1)})):(i(t,L)||M(t,L,S(1,{})),t[L][n]=!0),q(t,n,r)):M(t,n,r)},H=function(t,n){m(t);for(var r,e=g(n=x(n)),i=0,o=e.length;o>i;)Y(t,r=e[i++],n[r]);return t},$=function(t,n){return void 0===n?_(t):H(_(t),n)},X=function(t){var n=C.call(this,t=w(t,!0));return!(this===G&&i(U,t)&&!i(W,t))&&(!(n||!i(this,t)||!i(U,t)||i(this,L)&&this[L][t])||n)},Q=function(t,n){if(t=x(t),n=w(n,!0),t!==G||!i(U,n)||i(W,n)){var r=F(t,n);return!r||!i(U,n)||i(t,L)&&t[L][n]||(r.enumerable=!0),r}},Z=function(t){for(var n,r=A(x(t)),e=[],o=0;r.length>o;)i(U,n=r[o++])||n==L||n==f||e.push(n);return e},tt=function(t){for(var n,r=t===G,e=A(r?W:x(t)),o=[],u=0;e.length>u;)!i(U,n=e[u++])||r&&!i(G,n)||o.push(U[n]);return o};B||(N=function(){if(this instanceof N)throw TypeError("Symbol is not a constructor!");var t=h(arguments.length>0?arguments[0]:void 0),n=function(r){this===G&&n.call(W,r),i(this,L)&&i(this[L],t)&&(this[L][t]=!1),q(this,t,S(1,r))};return o&&z&&q(G,t,{configurable:!0,set:n}),K(t)},c(N[k],"toString",function(){return this._k}),E.f=Q,P.f=Y,r(61).f=O.f=Z,r(37).f=X,r(62).f=tt,o&&!r(36)&&c(G,"propertyIsEnumerable",X,!0),p.f=function(t){return K(v(t))}),u(u.G+u.W+u.F*!B,{Symbol:N});for(var nt="hasInstance,isConcatSpreadable,iterator,match,replace,search,species,split,toPrimitive,toStringTag,unscopables".split(","),rt=0;nt.length>rt;)v(nt[rt++]);for(var nt=j(v.store),rt=0;nt.length>rt;)d(nt[rt++]);u(u.S+u.F*!B,"Symbol",{for:function(t){return i(D,t+="")?D[t]:D[t]=N(t)},keyFor:function(t){if(J(t))return y(D,t);throw TypeError(t+" is not a symbol!")},useSetter:function(){z=!0},useSimple:function(){z=!1}}),u(u.S+u.F*!B,"Object",{create:$,defineProperty:Y,defineProperties:H,getOwnPropertyDescriptor:Q,getOwnPropertyNames:Z,getOwnPropertySymbols:tt}),T&&u(u.S+u.F*(!B||a(function(){var t=N();return"[null]"!=I([t])||"{}"!=I({a:t})||"{}"!=I(Object(t))})),"JSON",{stringify:function(t){if(void 0!==t&&!J(t)){for(var n,r,e=[t],i=1;arguments.length>i;)e.push(arguments[i++]);return n=e[1],"function"==typeof n&&(r=n),!r&&b(n)||(n=function(t,n){if(r&&(n=r.call(this,t,n)),!J(n))return n}),e[1]=n,I.apply(T,e)}}}),N[k][R]||r(13)(N[k],R,N[k].valueOf),l(N,"Symbol"),l(Math,"Math",!0),l(e.JSON,"JSON",!0)},function(t,n,r){r(43)("asyncIterator")},function(t,n,r){r(43)("observable")},function(t,n,r){r(107);for(var e=r(5),i=r(13),o=r(35),u=r(15)("toStringTag"),c=["NodeList","DOMTokenList","MediaList","StyleSheetList","CSSRuleList"],f=0;f<5;f++){var a=c[f],s=e[a],l=s&&s.prototype;l&&!l[u]&&i(l,u,a),o[a]=o.Array}},function(t,n,r){var e=r(45),i=r(7)("toStringTag"),o="Arguments"==e(function(){return arguments}()),u=function(t,n){try{return t[n]}catch(t){}};t.exports=function(t){var n,r,c;return void 0===t?"Undefined":null===t?"Null":"string"==typeof(r=u(n=Object(t),i))?r:o?e(n):"Object"==(c=e(n))&&"function"==typeof n.callee?"Arguments":c}},function(t,n,r){var e=r(45);t.exports=Object("z").propertyIsEnumerable(0)?Object:function(t){return"String"==e(t)?t.split(""):Object(t)}},function(t,n){n.f={}.propertyIsEnumerable},function(t,n,r){var e=r(30),i=r(16),o=r(75);t.exports=function(t){return function(n,r,u){var c,f=e(n),a=i(f.length),s=o(u,a);if(t&&r!=r){for(;a>s;)if((c=f[s++])!=c)return!0}else for(;a>s;s++)if((t||s in f)&&f[s]===r)return t||s||0;return!t&&-1}}},function(t,n,r){"use strict";var e=r(3),i=r(1),o=r(28),u=r(73),c=r(65),f=r(79),a=r(68),s=r(6),l=r(4),h=r(123),v=r(81),p=r(136);t.exports=function(t,n,r,d,y,g){var b=e[t],m=b,x=y?"set":"add",w=m&&m.prototype,S={},_=function(t){var n=w[t];o(w,t,"delete"==t?function(t){return!(g&&!s(t))&&n.call(this,0===t?0:t)}:"has"==t?function(t){return!(g&&!s(t))&&n.call(this,0===t?0:t)}:"get"==t?function(t){return g&&!s(t)?void 0:n.call(this,0===t?0:t)}:"add"==t?function(t){return n.call(this,0===t?0:t),this}:function(t,r){return n.call(this,0===t?0:t,r),this})};if("function"==typeof m&&(g||w.forEach&&!l(function(){(new m).entries().next()}))){var O=new m,E=O[x](g?{}:-0,1)!=O,P=l(function(){O.has(1)}),j=h(function(t){new m(t)}),F=!g&&l(function(){for(var t=new m,n=5;n--;)t[x](n,n);return!t.has(-0)});j||(m=n(function(n,r){a(n,m,t);var e=p(new b,n,m);return void 0!=r&&f(r,y,e[x],e),e}),m.prototype=w,w.constructor=m),(P||F)&&(_("delete"),_("has"),y&&_("get")),(F||E)&&_(x),g&&w.clear&&delete w.clear}else m=d.getConstructor(n,t,y,x),u(m.prototype,r),c.NEED=!0;return v(m,t),S[t]=m,i(i.G+i.W+i.F*(m!=b),S),g||d.setStrong(m,t,y),m}},function(t,n,r){"use strict";var e=r(27),i=r(28),o=r(4),u=r(46),c=r(7);t.exports=function(t,n,r){var f=c(t),a=r(u,f,""[t]),s=a[0],l=a[1];o(function(){var n={};return n[f]=function(){return 7},7!=""[t](n)})&&(i(String.prototype,t,s),e(RegExp.prototype,f,2==n?function(t,n){return l.call(t,this,n)}:function(t){return l.call(t,this)}))} },function(t,n,r){"use strict";var e=r(2);t.exports=function(){var t=e(this),n="";return t.global&&(n+="g"),t.ignoreCase&&(n+="i"),t.multiline&&(n+="m"),t.unicode&&(n+="u"),t.sticky&&(n+="y"),n}},function(t,n){t.exports=function(t,n,r){var e=void 0===r;switch(n.length){case 0:return e?t():t.call(r);case 1:return e?t(n[0]):t.call(r,n[0]);case 2:return e?t(n[0],n[1]):t.call(r,n[0],n[1]);case 3:return e?t(n[0],n[1],n[2]):t.call(r,n[0],n[1],n[2]);case 4:return e?t(n[0],n[1],n[2],n[3]):t.call(r,n[0],n[1],n[2],n[3])}return t.apply(r,n)}},function(t,n,r){var e=r(6),i=r(45),o=r(7)("match");t.exports=function(t){var n;return e(t)&&(void 0!==(n=t[o])?!!n:"RegExp"==i(t))}},function(t,n,r){var e=r(7)("iterator"),i=!1;try{var o=[7][e]();o.return=function(){i=!0},Array.from(o,function(){throw 2})}catch(t){}t.exports=function(t,n){if(!n&&!i)return!1;var r=!1;try{var o=[7],u=o[e]();u.next=function(){return{done:r=!0}},o[e]=function(){return u},t(o)}catch(t){}return r}},function(t,n,r){t.exports=r(69)||!r(4)(function(){var t=Math.random();__defineSetter__.call(null,t,function(){}),delete r(3)[t]})},function(t,n){n.f=Object.getOwnPropertySymbols},function(t,n,r){var e=r(3),i="__core-js_shared__",o=e[i]||(e[i]={});t.exports=function(t){return o[t]||(o[t]={})}},function(t,n,r){for(var e,i=r(3),o=r(27),u=r(76),c=u("typed_array"),f=u("view"),a=!(!i.ArrayBuffer||!i.DataView),s=a,l=0,h="Int8Array,Uint8Array,Uint8ClampedArray,Int16Array,Uint16Array,Int32Array,Uint32Array,Float32Array,Float64Array".split(",");l<9;)(e=i[h[l++]])?(o(e.prototype,c,!0),o(e.prototype,f,!0)):s=!1;t.exports={ABV:a,CONSTR:s,TYPED:c,VIEW:f}},function(t,n){"use strict";var r={versions:function(){var t=window.navigator.userAgent;return{trident:t.indexOf("Trident")>-1,presto:t.indexOf("Presto")>-1,webKit:t.indexOf("AppleWebKit")>-1,gecko:t.indexOf("Gecko")>-1&&-1==t.indexOf("KHTML"),mobile:!!t.match(/AppleWebKit.*Mobile.*/),ios:!!t.match(/\(i[^;]+;( U;)? CPU.+Mac OS X/),android:t.indexOf("Android")>-1||t.indexOf("Linux")>-1,iPhone:t.indexOf("iPhone")>-1||t.indexOf("Mac")>-1,iPad:t.indexOf("iPad")>-1,webApp:-1==t.indexOf("Safari"),weixin:-1==t.indexOf("MicroMessenger")}}()};t.exports=r},function(t,n,r){"use strict";var e=r(85),i=function(t){return t&&t.__esModule?t:{default:t}}(e),o=function(){function t(t,n,e){return n||e?String.fromCharCode(n||e):r[t]||t}function n(t){return e[t]}var r={""":'"',"<":"<",">":">","&":"&"," ":" "},e={};for(var u in r)e[r[u]]=u;return r["'"]="'",e["'"]="'",{encode:function(t){return t?(""+t).replace(/['<> "&]/g,n).replace(/\r?\n/g,"<br/>").replace(/\s/g," "):""},decode:function(n){return n?(""+n).replace(/<br\s*\/?>/gi,"\n").replace(/"|<|>|&| |'|&#(\d+);|&#(\d+)/g,t).replace(/\u00a0/g," "):""},encodeBase16:function(t){if(!t)return t;t+="";for(var n=[],r=0,e=t.length;e>r;r++)n.push(t.charCodeAt(r).toString(16).toUpperCase());return n.join("")},encodeBase16forJSON:function(t){if(!t)return t;t=t.replace(/[\u4E00-\u9FBF]/gi,function(t){return escape(t).replace("%u","\\u")});for(var n=[],r=0,e=t.length;e>r;r++)n.push(t.charCodeAt(r).toString(16).toUpperCase());return n.join("")},decodeBase16:function(t){if(!t)return t;t+="";for(var n=[],r=0,e=t.length;e>r;r+=2)n.push(String.fromCharCode("0x"+t.slice(r,r+2)));return n.join("")},encodeObject:function(t){if(t instanceof Array)for(var n=0,r=t.length;r>n;n++)t[n]=o.encodeObject(t[n]);else if("object"==(void 0===t?"undefined":(0,i.default)(t)))for(var e in t)t[e]=o.encodeObject(t[e]);else if("string"==typeof t)return o.encode(t);return t},loadScript:function(t){var n=document.createElement("script");document.getElementsByTagName("body")[0].appendChild(n),n.setAttribute("src",t)},addLoadEvent:function(t){var n=window.onload;"function"!=typeof window.onload?window.onload=t:window.onload=function(){n(),t()}}}}();t.exports=o},function(t,n,r){"use strict";var e=r(17),i=r(75),o=r(16);t.exports=function(t){for(var n=e(this),r=o(n.length),u=arguments.length,c=i(u>1?arguments[1]:void 0,r),f=u>2?arguments[2]:void 0,a=void 0===f?r:i(f,r);a>c;)n[c++]=t;return n}},function(t,n,r){"use strict";var e=r(11),i=r(66);t.exports=function(t,n,r){n in t?e.f(t,n,i(0,r)):t[n]=r}},function(t,n,r){var e=r(6),i=r(3).document,o=e(i)&&e(i.createElement);t.exports=function(t){return o?i.createElement(t):{}}},function(t,n){t.exports="constructor,hasOwnProperty,isPrototypeOf,propertyIsEnumerable,toLocaleString,toString,valueOf".split(",")},function(t,n,r){var e=r(7)("match");t.exports=function(t){var n=/./;try{"/./"[t](n)}catch(r){try{return n[e]=!1,!"/./"[t](n)}catch(t){}}return!0}},function(t,n,r){t.exports=r(3).document&&document.documentElement},function(t,n,r){var e=r(6),i=r(144).set;t.exports=function(t,n,r){var o,u=n.constructor;return u!==r&&"function"==typeof u&&(o=u.prototype)!==r.prototype&&e(o)&&i&&i(t,o),t}},function(t,n,r){var e=r(80),i=r(7)("iterator"),o=Array.prototype;t.exports=function(t){return void 0!==t&&(e.Array===t||o[i]===t)}},function(t,n,r){var e=r(45);t.exports=Array.isArray||function(t){return"Array"==e(t)}},function(t,n,r){"use strict";var e=r(70),i=r(66),o=r(81),u={};r(27)(u,r(7)("iterator"),function(){return this}),t.exports=function(t,n,r){t.prototype=e(u,{next:i(1,r)}),o(t,n+" Iterator")}},function(t,n,r){"use strict";var e=r(69),i=r(1),o=r(28),u=r(27),c=r(24),f=r(80),a=r(139),s=r(81),l=r(32),h=r(7)("iterator"),v=!([].keys&&"next"in[].keys()),p="keys",d="values",y=function(){return this};t.exports=function(t,n,r,g,b,m,x){a(r,n,g);var w,S,_,O=function(t){if(!v&&t in F)return F[t];switch(t){case p:case d:return function(){return new r(this,t)}}return function(){return new r(this,t)}},E=n+" Iterator",P=b==d,j=!1,F=t.prototype,M=F[h]||F["@@iterator"]||b&&F[b],A=M||O(b),N=b?P?O("entries"):A:void 0,T="Array"==n?F.entries||M:M;if(T&&(_=l(T.call(new t)))!==Object.prototype&&(s(_,E,!0),e||c(_,h)||u(_,h,y)),P&&M&&M.name!==d&&(j=!0,A=function(){return M.call(this)}),e&&!x||!v&&!j&&F[h]||u(F,h,A),f[n]=A,f[E]=y,b)if(w={values:P?A:O(d),keys:m?A:O(p),entries:N},x)for(S in w)S in F||o(F,S,w[S]);else i(i.P+i.F*(v||j),n,w);return w}},function(t,n){var r=Math.expm1;t.exports=!r||r(10)>22025.465794806718||r(10)<22025.465794806718||-2e-17!=r(-2e-17)?function(t){return 0==(t=+t)?t:t>-1e-6&&t<1e-6?t+t*t/2:Math.exp(t)-1}:r},function(t,n){t.exports=Math.sign||function(t){return 0==(t=+t)||t!=t?t:t<0?-1:1}},function(t,n,r){var e=r(3),i=r(151).set,o=e.MutationObserver||e.WebKitMutationObserver,u=e.process,c=e.Promise,f="process"==r(45)(u);t.exports=function(){var t,n,r,a=function(){var e,i;for(f&&(e=u.domain)&&e.exit();t;){i=t.fn,t=t.next;try{i()}catch(e){throw t?r():n=void 0,e}}n=void 0,e&&e.enter()};if(f)r=function(){u.nextTick(a)};else if(o){var s=!0,l=document.createTextNode("");new o(a).observe(l,{characterData:!0}),r=function(){l.data=s=!s}}else if(c&&c.resolve){var h=c.resolve();r=function(){h.then(a)}}else r=function(){i.call(e,a)};return function(e){var i={fn:e,next:void 0};n&&(n.next=i),t||(t=i,r()),n=i}}},function(t,n,r){var e=r(6),i=r(2),o=function(t,n){if(i(t),!e(n)&&null!==n)throw TypeError(n+": can't set as prototype!")};t.exports={set:Object.setPrototypeOf||("__proto__"in{}?function(t,n,e){try{e=r(53)(Function.call,r(31).f(Object.prototype,"__proto__").set,2),e(t,[]),n=!(t instanceof Array)}catch(t){n=!0}return function(t,r){return o(t,r),n?t.__proto__=r:e(t,r),t}}({},!1):void 0),check:o}},function(t,n,r){var e=r(126)("keys"),i=r(76);t.exports=function(t){return e[t]||(e[t]=i(t))}},function(t,n,r){var e=r(2),i=r(26),o=r(7)("species");t.exports=function(t,n){var r,u=e(t).constructor;return void 0===u||void 0==(r=e(u)[o])?n:i(r)}},function(t,n,r){var e=r(67),i=r(46);t.exports=function(t){return function(n,r){var o,u,c=String(i(n)),f=e(r),a=c.length;return f<0||f>=a?t?"":void 0:(o=c.charCodeAt(f),o<55296||o>56319||f+1===a||(u=c.charCodeAt(f+1))<56320||u>57343?t?c.charAt(f):o:t?c.slice(f,f+2):u-56320+(o-55296<<10)+65536)}}},function(t,n,r){var e=r(122),i=r(46);t.exports=function(t,n,r){if(e(n))throw TypeError("String#"+r+" doesn't accept regex!");return String(i(t))}},function(t,n,r){"use strict";var e=r(67),i=r(46);t.exports=function(t){var n=String(i(this)),r="",o=e(t);if(o<0||o==1/0)throw RangeError("Count can't be negative");for(;o>0;(o>>>=1)&&(n+=n))1&o&&(r+=n);return r}},function(t,n){t.exports="\t\n\v\f\r \u2028\u2029\ufeff"},function(t,n,r){var e,i,o,u=r(53),c=r(121),f=r(135),a=r(132),s=r(3),l=s.process,h=s.setImmediate,v=s.clearImmediate,p=s.MessageChannel,d=0,y={},g="onreadystatechange",b=function(){var t=+this;if(y.hasOwnProperty(t)){var n=y[t];delete y[t],n()}},m=function(t){b.call(t.data)};h&&v||(h=function(t){for(var n=[],r=1;arguments.length>r;)n.push(arguments[r++]);return y[++d]=function(){c("function"==typeof t?t:Function(t),n)},e(d),d},v=function(t){delete y[t]},"process"==r(45)(l)?e=function(t){l.nextTick(u(b,t,1))}:p?(i=new p,o=i.port2,i.port1.onmessage=m,e=u(o.postMessage,o,1)):s.addEventListener&&"function"==typeof postMessage&&!s.importScripts?(e=function(t){s.postMessage(t+"","*")},s.addEventListener("message",m,!1)):e=g in a("script")?function(t){f.appendChild(a("script"))[g]=function(){f.removeChild(this),b.call(t)}}:function(t){setTimeout(u(b,t,1),0)}),t.exports={set:h,clear:v}},function(t,n,r){"use strict";var e=r(3),i=r(10),o=r(69),u=r(127),c=r(27),f=r(73),a=r(4),s=r(68),l=r(67),h=r(16),v=r(71).f,p=r(11).f,d=r(130),y=r(81),g="ArrayBuffer",b="DataView",m="prototype",x="Wrong length!",w="Wrong index!",S=e[g],_=e[b],O=e.Math,E=e.RangeError,P=e.Infinity,j=S,F=O.abs,M=O.pow,A=O.floor,N=O.log,T=O.LN2,I="buffer",k="byteLength",L="byteOffset",R=i?"_b":I,C=i?"_l":k,D=i?"_o":L,U=function(t,n,r){var e,i,o,u=Array(r),c=8*r-n-1,f=(1<<c)-1,a=f>>1,s=23===n?M(2,-24)-M(2,-77):0,l=0,h=t<0||0===t&&1/t<0?1:0;for(t=F(t),t!=t||t===P?(i=t!=t?1:0,e=f):(e=A(N(t)/T),t*(o=M(2,-e))<1&&(e--,o*=2),t+=e+a>=1?s/o:s*M(2,1-a),t*o>=2&&(e++,o/=2),e+a>=f?(i=0,e=f):e+a>=1?(i=(t*o-1)*M(2,n),e+=a):(i=t*M(2,a-1)*M(2,n),e=0));n>=8;u[l++]=255&i,i/=256,n-=8);for(e=e<<n|i,c+=n;c>0;u[l++]=255&e,e/=256,c-=8);return u[--l]|=128*h,u},W=function(t,n,r){var e,i=8*r-n-1,o=(1<<i)-1,u=o>>1,c=i-7,f=r-1,a=t[f--],s=127&a;for(a>>=7;c>0;s=256*s+t[f],f--,c-=8);for(e=s&(1<<-c)-1,s>>=-c,c+=n;c>0;e=256*e+t[f],f--,c-=8);if(0===s)s=1-u;else{if(s===o)return e?NaN:a?-P:P;e+=M(2,n),s-=u}return(a?-1:1)*e*M(2,s-n)},G=function(t){return t[3]<<24|t[2]<<16|t[1]<<8|t[0]},B=function(t){return[255&t]},V=function(t){return[255&t,t>>8&255]},z=function(t){return[255&t,t>>8&255,t>>16&255,t>>24&255]},q=function(t){return U(t,52,8)},K=function(t){return U(t,23,4)},J=function(t,n,r){p(t[m],n,{get:function(){return this[r]}})},Y=function(t,n,r,e){var i=+r,o=l(i);if(i!=o||o<0||o+n>t[C])throw E(w);var u=t[R]._b,c=o+t[D],f=u.slice(c,c+n);return e?f:f.reverse()},H=function(t,n,r,e,i,o){var u=+r,c=l(u);if(u!=c||c<0||c+n>t[C])throw E(w);for(var f=t[R]._b,a=c+t[D],s=e(+i),h=0;h<n;h++)f[a+h]=s[o?h:n-h-1]},$=function(t,n){s(t,S,g);var r=+n,e=h(r);if(r!=e)throw E(x);return e};if(u.ABV){if(!a(function(){new S})||!a(function(){new S(.5)})){S=function(t){return new j($(this,t))};for(var X,Q=S[m]=j[m],Z=v(j),tt=0;Z.length>tt;)(X=Z[tt++])in S||c(S,X,j[X]);o||(Q.constructor=S)}var nt=new _(new S(2)),rt=_[m].setInt8;nt.setInt8(0,2147483648),nt.setInt8(1,2147483649),!nt.getInt8(0)&&nt.getInt8(1)||f(_[m],{setInt8:function(t,n){rt.call(this,t,n<<24>>24)},setUint8:function(t,n){rt.call(this,t,n<<24>>24)}},!0)}else S=function(t){var n=$(this,t);this._b=d.call(Array(n),0),this[C]=n},_=function(t,n,r){s(this,_,b),s(t,S,b);var e=t[C],i=l(n);if(i<0||i>e)throw E("Wrong offset!");if(r=void 0===r?e-i:h(r),i+r>e)throw E(x);this[R]=t,this[D]=i,this[C]=r},i&&(J(S,k,"_l"),J(_,I,"_b"),J(_,k,"_l"),J(_,L,"_o")),f(_[m],{getInt8:function(t){return Y(this,1,t)[0]<<24>>24},getUint8:function(t){return Y(this,1,t)[0]},getInt16:function(t){var n=Y(this,2,t,arguments[1]);return(n[1]<<8|n[0])<<16>>16},getUint16:function(t){var n=Y(this,2,t,arguments[1]);return n[1]<<8|n[0]},getInt32:function(t){return G(Y(this,4,t,arguments[1]))},getUint32:function(t){return G(Y(this,4,t,arguments[1]))>>>0},getFloat32:function(t){return W(Y(this,4,t,arguments[1]),23,4)},getFloat64:function(t){return W(Y(this,8,t,arguments[1]),52,8)},setInt8:function(t,n){H(this,1,t,B,n)},setUint8:function(t,n){H(this,1,t,B,n)},setInt16:function(t,n){H(this,2,t,V,n,arguments[2])},setUint16:function(t,n){H(this,2,t,V,n,arguments[2])},setInt32:function(t,n){H(this,4,t,z,n,arguments[2])},setUint32:function(t,n){H(this,4,t,z,n,arguments[2])},setFloat32:function(t,n){H(this,4,t,K,n,arguments[2])},setFloat64:function(t,n){H(this,8,t,q,n,arguments[2])}});y(S,g),y(_,b),c(_[m],u.VIEW,!0),n[g]=S,n[b]=_},function(t,n,r){var e=r(3),i=r(52),o=r(69),u=r(182),c=r(11).f;t.exports=function(t){var n=i.Symbol||(i.Symbol=o?{}:e.Symbol||{});"_"==t.charAt(0)||t in n||c(n,t,{value:u.f(t)})}},function(t,n,r){var e=r(114),i=r(7)("iterator"),o=r(80);t.exports=r(52).getIteratorMethod=function(t){if(void 0!=t)return t[i]||t["@@iterator"]||o[e(t)]}},function(t,n,r){"use strict";var e=r(78),i=r(170),o=r(80),u=r(30);t.exports=r(140)(Array,"Array",function(t,n){this._t=u(t),this._i=0,this._k=n},function(){var t=this._t,n=this._k,r=this._i++;return!t||r>=t.length?(this._t=void 0,i(1)):"keys"==n?i(0,r):"values"==n?i(0,t[r]):i(0,[r,t[r]])},"values"),o.Arguments=o.Array,e("keys"),e("values"),e("entries")},function(t,n){function r(t,n){t.classList?t.classList.add(n):t.className+=" "+n}t.exports=r},function(t,n){function r(t,n){if(t.classList)t.classList.remove(n);else{var r=new RegExp("(^|\\b)"+n.split(" ").join("|")+"(\\b|$)","gi");t.className=t.className.replace(r," ")}}t.exports=r},function(t,n){function r(){throw new Error("setTimeout has not been defined")}function e(){throw new Error("clearTimeout has not been defined")}function i(t){if(s===setTimeout)return setTimeout(t,0);if((s===r||!s)&&setTimeout)return s=setTimeout,setTimeout(t,0);try{return s(t,0)}catch(n){try{return s.call(null,t,0)}catch(n){return s.call(this,t,0)}}}function o(t){if(l===clearTimeout)return clearTimeout(t);if((l===e||!l)&&clearTimeout)return l=clearTimeout,clearTimeout(t);try{return l(t)}catch(n){try{return l.call(null,t)}catch(n){return l.call(this,t)}}}function u(){d&&v&&(d=!1,v.length?p=v.concat(p):y=-1,p.length&&c())}function c(){if(!d){var t=i(u);d=!0;for(var n=p.length;n;){for(v=p,p=[];++y<n;)v&&v[y].run();y=-1,n=p.length}v=null,d=!1,o(t)}}function f(t,n){this.fun=t,this.array=n}function a(){}var s,l,h=t.exports={};!function(){try{s="function"==typeof setTimeout?setTimeout:r}catch(t){s=r}try{l="function"==typeof clearTimeout?clearTimeout:e}catch(t){l=e}}();var v,p=[],d=!1,y=-1;h.nextTick=function(t){var n=new Array(arguments.length-1);if(arguments.length>1)for(var r=1;r<arguments.length;r++)n[r-1]=arguments[r];p.push(new f(t,n)),1!==p.length||d||i(c)},f.prototype.run=function(){this.fun.apply(null,this.array)},h.title="browser",h.browser=!0,h.env={},h.argv=[],h.version="",h.versions={},h.on=a,h.addListener=a,h.once=a,h.off=a,h.removeListener=a,h.removeAllListeners=a,h.emit=a,h.prependListener=a,h.prependOnceListener=a,h.listeners=function(t){return[]},h.binding=function(t){throw new Error("process.binding is not supported")},h.cwd=function(){return"/"},h.chdir=function(t){throw new Error("process.chdir is not supported")},h.umask=function(){return 0}},function(t,n,r){var e=r(45);t.exports=function(t,n){if("number"!=typeof t&&"Number"!=e(t))throw TypeError(n);return+t}},function(t,n,r){"use strict";var e=r(17),i=r(75),o=r(16);t.exports=[].copyWithin||function(t,n){var r=e(this),u=o(r.length),c=i(t,u),f=i(n,u),a=arguments.length>2?arguments[2]:void 0,s=Math.min((void 0===a?u:i(a,u))-f,u-c),l=1;for(f<c&&c<f+s&&(l=-1,f+=s-1,c+=s-1);s-- >0;)f in r?r[c]=r[f]:delete r[c],c+=l,f+=l;return r}},function(t,n,r){var e=r(79);t.exports=function(t,n){var r=[];return e(t,!1,r.push,r,n),r}},function(t,n,r){var e=r(26),i=r(17),o=r(115),u=r(16);t.exports=function(t,n,r,c,f){e(n);var a=i(t),s=o(a),l=u(a.length),h=f?l-1:0,v=f?-1:1;if(r<2)for(;;){if(h in s){c=s[h],h+=v;break}if(h+=v,f?h<0:l<=h)throw TypeError("Reduce of empty array with no initial value")}for(;f?h>=0:l>h;h+=v)h in s&&(c=n(c,s[h],h,a));return c}},function(t,n,r){"use strict";var e=r(26),i=r(6),o=r(121),u=[].slice,c={},f=function(t,n,r){if(!(n in c)){for(var e=[],i=0;i<n;i++)e[i]="a["+i+"]";c[n]=Function("F,a","return new F("+e.join(",")+")")}return c[n](t,r)};t.exports=Function.bind||function(t){var n=e(this),r=u.call(arguments,1),c=function(){var e=r.concat(u.call(arguments));return this instanceof c?f(n,e.length,e):o(n,e,t)};return i(n.prototype)&&(c.prototype=n.prototype),c}},function(t,n,r){"use strict";var e=r(11).f,i=r(70),o=r(73),u=r(53),c=r(68),f=r(46),a=r(79),s=r(140),l=r(170),h=r(74),v=r(10),p=r(65).fastKey,d=v?"_s":"size",y=function(t,n){var r,e=p(n);if("F"!==e)return t._i[e];for(r=t._f;r;r=r.n)if(r.k==n)return r};t.exports={getConstructor:function(t,n,r,s){var l=t(function(t,e){c(t,l,n,"_i"),t._i=i(null),t._f=void 0,t._l=void 0,t[d]=0,void 0!=e&&a(e,r,t[s],t)});return o(l.prototype,{clear:function(){for(var t=this,n=t._i,r=t._f;r;r=r.n)r.r=!0,r.p&&(r.p=r.p.n=void 0),delete n[r.i];t._f=t._l=void 0,t[d]=0},delete:function(t){var n=this,r=y(n,t);if(r){var e=r.n,i=r.p;delete n._i[r.i],r.r=!0,i&&(i.n=e),e&&(e.p=i),n._f==r&&(n._f=e),n._l==r&&(n._l=i),n[d]--}return!!r},forEach:function(t){c(this,l,"forEach");for(var n,r=u(t,arguments.length>1?arguments[1]:void 0,3);n=n?n.n:this._f;)for(r(n.v,n.k,this);n&&n.r;)n=n.p},has:function(t){return!!y(this,t)}}),v&&e(l.prototype,"size",{get:function(){return f(this[d])}}),l},def:function(t,n,r){var e,i,o=y(t,n);return o?o.v=r:(t._l=o={i:i=p(n,!0),k:n,v:r,p:e=t._l,n:void 0,r:!1},t._f||(t._f=o),e&&(e.n=o),t[d]++,"F"!==i&&(t._i[i]=o)),t},getEntry:y,setStrong:function(t,n,r){s(t,n,function(t,n){this._t=t,this._k=n,this._l=void 0},function(){for(var t=this,n=t._k,r=t._l;r&&r.r;)r=r.p;return t._t&&(t._l=r=r?r.n:t._t._f)?"keys"==n?l(0,r.k):"values"==n?l(0,r.v):l(0,[r.k,r.v]):(t._t=void 0,l(1))},r?"entries":"values",!r,!0),h(n)}}},function(t,n,r){var e=r(114),i=r(161);t.exports=function(t){return function(){if(e(this)!=t)throw TypeError(t+"#toJSON isn't generic");return i(this)}}},function(t,n,r){"use strict";var e=r(73),i=r(65).getWeak,o=r(2),u=r(6),c=r(68),f=r(79),a=r(48),s=r(24),l=a(5),h=a(6),v=0,p=function(t){return t._l||(t._l=new d)},d=function(){this.a=[]},y=function(t,n){return l(t.a,function(t){return t[0]===n})};d.prototype={get:function(t){var n=y(this,t);if(n)return n[1]},has:function(t){return!!y(this,t)},set:function(t,n){var r=y(this,t);r?r[1]=n:this.a.push([t,n])},delete:function(t){var n=h(this.a,function(n){return n[0]===t});return~n&&this.a.splice(n,1),!!~n}},t.exports={getConstructor:function(t,n,r,o){var a=t(function(t,e){c(t,a,n,"_i"),t._i=v++,t._l=void 0,void 0!=e&&f(e,r,t[o],t)});return e(a.prototype,{delete:function(t){if(!u(t))return!1;var n=i(t);return!0===n?p(this).delete(t):n&&s(n,this._i)&&delete n[this._i]},has:function(t){if(!u(t))return!1;var n=i(t);return!0===n?p(this).has(t):n&&s(n,this._i)}}),a},def:function(t,n,r){var e=i(o(n),!0);return!0===e?p(t).set(n,r):e[t._i]=r,t},ufstore:p}},function(t,n,r){t.exports=!r(10)&&!r(4)(function(){return 7!=Object.defineProperty(r(132)("div"),"a",{get:function(){return 7}}).a})},function(t,n,r){var e=r(6),i=Math.floor;t.exports=function(t){return!e(t)&&isFinite(t)&&i(t)===t}},function(t,n,r){var e=r(2);t.exports=function(t,n,r,i){try{return i?n(e(r)[0],r[1]):n(r)}catch(n){var o=t.return;throw void 0!==o&&e(o.call(t)),n}}},function(t,n){t.exports=function(t,n){return{value:n,done:!!t}}},function(t,n){t.exports=Math.log1p||function(t){return(t=+t)>-1e-8&&t<1e-8?t-t*t/2:Math.log(1+t)}},function(t,n,r){"use strict";var e=r(72),i=r(125),o=r(116),u=r(17),c=r(115),f=Object.assign;t.exports=!f||r(4)(function(){var t={},n={},r=Symbol(),e="abcdefghijklmnopqrst";return t[r]=7,e.split("").forEach(function(t){n[t]=t}),7!=f({},t)[r]||Object.keys(f({},n)).join("")!=e})?function(t,n){for(var r=u(t),f=arguments.length,a=1,s=i.f,l=o.f;f>a;)for(var h,v=c(arguments[a++]),p=s?e(v).concat(s(v)):e(v),d=p.length,y=0;d>y;)l.call(v,h=p[y++])&&(r[h]=v[h]);return r}:f},function(t,n,r){var e=r(11),i=r(2),o=r(72);t.exports=r(10)?Object.defineProperties:function(t,n){i(t);for(var r,u=o(n),c=u.length,f=0;c>f;)e.f(t,r=u[f++],n[r]);return t}},function(t,n,r){var e=r(30),i=r(71).f,o={}.toString,u="object"==typeof window&&window&&Object.getOwnPropertyNames?Object.getOwnPropertyNames(window):[],c=function(t){try{return i(t)}catch(t){return u.slice()}};t.exports.f=function(t){return u&&"[object Window]"==o.call(t)?c(t):i(e(t))}},function(t,n,r){var e=r(24),i=r(30),o=r(117)(!1),u=r(145)("IE_PROTO");t.exports=function(t,n){var r,c=i(t),f=0,a=[];for(r in c)r!=u&&e(c,r)&&a.push(r);for(;n.length>f;)e(c,r=n[f++])&&(~o(a,r)||a.push(r));return a}},function(t,n,r){var e=r(72),i=r(30),o=r(116).f;t.exports=function(t){return function(n){for(var r,u=i(n),c=e(u),f=c.length,a=0,s=[];f>a;)o.call(u,r=c[a++])&&s.push(t?[r,u[r]]:u[r]);return s}}},function(t,n,r){var e=r(71),i=r(125),o=r(2),u=r(3).Reflect;t.exports=u&&u.ownKeys||function(t){var n=e.f(o(t)),r=i.f;return r?n.concat(r(t)):n}},function(t,n,r){var e=r(3).parseFloat,i=r(82).trim;t.exports=1/e(r(150)+"-0")!=-1/0?function(t){var n=i(String(t),3),r=e(n);return 0===r&&"-"==n.charAt(0)?-0:r}:e},function(t,n,r){var e=r(3).parseInt,i=r(82).trim,o=r(150),u=/^[\-+]?0[xX]/;t.exports=8!==e(o+"08")||22!==e(o+"0x16")?function(t,n){var r=i(String(t),3);return e(r,n>>>0||(u.test(r)?16:10))}:e},function(t,n){t.exports=Object.is||function(t,n){return t===n?0!==t||1/t==1/n:t!=t&&n!=n}},function(t,n,r){var e=r(16),i=r(149),o=r(46);t.exports=function(t,n,r,u){var c=String(o(t)),f=c.length,a=void 0===r?" ":String(r),s=e(n);if(s<=f||""==a)return c;var l=s-f,h=i.call(a,Math.ceil(l/a.length));return h.length>l&&(h=h.slice(0,l)),u?h+c:c+h}},function(t,n,r){n.f=r(7)},function(t,n,r){"use strict";var e=r(164);t.exports=r(118)("Map",function(t){return function(){return t(this,arguments.length>0?arguments[0]:void 0)}},{get:function(t){var n=e.getEntry(this,t);return n&&n.v},set:function(t,n){return e.def(this,0===t?0:t,n)}},e,!0)},function(t,n,r){r(10)&&"g"!=/./g.flags&&r(11).f(RegExp.prototype,"flags",{configurable:!0,get:r(120)})},function(t,n,r){"use strict";var e=r(164);t.exports=r(118)("Set",function(t){return function(){return t(this,arguments.length>0?arguments[0]:void 0)}},{add:function(t){return e.def(this,t=0===t?0:t,t)}},e)},function(t,n,r){"use strict";var e,i=r(48)(0),o=r(28),u=r(65),c=r(172),f=r(166),a=r(6),s=u.getWeak,l=Object.isExtensible,h=f.ufstore,v={},p=function(t){return function(){return t(this,arguments.length>0?arguments[0]:void 0)}},d={get:function(t){if(a(t)){var n=s(t);return!0===n?h(this).get(t):n?n[this._i]:void 0}},set:function(t,n){return f.def(this,t,n)}},y=t.exports=r(118)("WeakMap",p,d,f,!0,!0);7!=(new y).set((Object.freeze||Object)(v),7).get(v)&&(e=f.getConstructor(p),c(e.prototype,d),u.NEED=!0,i(["delete","has","get","set"],function(t){var n=y.prototype,r=n[t];o(n,t,function(n,i){if(a(n)&&!l(n)){this._f||(this._f=new e);var o=this._f[t](n,i);return"set"==t?this:o}return r.call(this,n,i)})}))},,,,function(t,n){"use strict";function r(){var t=document.querySelector("#page-nav");if(t&&!document.querySelector("#page-nav .extend.prev")&&(t.innerHTML='<a class="extend prev disabled" rel="prev">« Prev</a>'+t.innerHTML),t&&!document.querySelector("#page-nav .extend.next")&&(t.innerHTML=t.innerHTML+'<a class="extend next disabled" rel="next">Next »</a>'),yiliaConfig&&yiliaConfig.open_in_new){document.querySelectorAll(".article-entry a:not(.article-more-a)").forEach(function(t){var n=t.getAttribute("target");n&&""!==n||t.setAttribute("target","_blank")})}if(yiliaConfig&&yiliaConfig.toc_hide_index){document.querySelectorAll(".toc-number").forEach(function(t){t.style.display="none"})}var n=document.querySelector("#js-aboutme");n&&0!==n.length&&(n.innerHTML=n.innerText)}t.exports={init:r}},function(t,n,r){"use strict";function e(t){return t&&t.__esModule?t:{default:t}}function i(t,n){var r=/\/|index.html/g;return t.replace(r,"")===n.replace(r,"")}function o(){for(var t=document.querySelectorAll(".js-header-menu li a"),n=window.location.pathname,r=0,e=t.length;r<e;r++){var o=t[r];i(n,o.getAttribute("href"))&&(0,h.default)(o,"active")}}function u(t){for(var n=t.offsetLeft,r=t.offsetParent;null!==r;)n+=r.offsetLeft,r=r.offsetParent;return n}function c(t){for(var n=t.offsetTop,r=t.offsetParent;null!==r;)n+=r.offsetTop,r=r.offsetParent;return n}function f(t,n,r,e,i){var o=u(t),f=c(t)-n;if(f-r<=i){var a=t.$newDom;a||(a=t.cloneNode(!0),(0,d.default)(t,a),t.$newDom=a,a.style.position="fixed",a.style.top=(r||f)+"px",a.style.left=o+"px",a.style.zIndex=e||2,a.style.width="100%",a.style.color="#fff"),a.style.visibility="visible",t.style.visibility="hidden"}else{t.style.visibility="visible";var s=t.$newDom;s&&(s.style.visibility="hidden")}}function a(){var t=document.querySelector(".js-overlay"),n=document.querySelector(".js-header-menu");f(t,document.body.scrollTop,-63,2,0),f(n,document.body.scrollTop,1,3,0)}function s(){document.querySelector("#container").addEventListener("scroll",function(t){a()}),window.addEventListener("scroll",function(t){a()}),a()}var l=r(156),h=e(l),v=r(157),p=(e(v),r(382)),d=e(p),y=r(128),g=e(y),b=r(190),m=e(b),x=r(129);(function(){g.default.versions.mobile&&window.screen.width<800&&(o(),s())})(),(0,x.addLoadEvent)(function(){m.default.init()}),t.exports={}},,,,function(t,n,r){(function(t){"use strict";function n(t,n,r){t[n]||Object[e](t,n,{writable:!0,configurable:!0,value:r})}if(r(381),r(391),r(198),t._babelPolyfill)throw new Error("only one instance of babel-polyfill is allowed");t._babelPolyfill=!0;var e="defineProperty";n(String.prototype,"padLeft","".padStart),n(String.prototype,"padRight","".padEnd),"pop,reverse,shift,keys,values,entries,indexOf,every,some,forEach,map,filter,find,findIndex,includes,join,slice,concat,push,splice,unshift,sort,lastIndexOf,reduce,reduceRight,copyWithin,fill".split(",").forEach(function(t){[][t]&&n(Array,t,Function.call.bind([][t]))})}).call(n,function(){return this}())},,,function(t,n,r){r(210),t.exports=r(52).RegExp.escape},,,,function(t,n,r){var e=r(6),i=r(138),o=r(7)("species");t.exports=function(t){var n;return i(t)&&(n=t.constructor,"function"!=typeof n||n!==Array&&!i(n.prototype)||(n=void 0),e(n)&&null===(n=n[o])&&(n=void 0)),void 0===n?Array:n}},function(t,n,r){var e=r(202);t.exports=function(t,n){return new(e(t))(n)}},function(t,n,r){"use strict";var e=r(2),i=r(50),o="number";t.exports=function(t){if("string"!==t&&t!==o&&"default"!==t)throw TypeError("Incorrect hint");return i(e(this),t!=o)}},function(t,n,r){var e=r(72),i=r(125),o=r(116);t.exports=function(t){var n=e(t),r=i.f;if(r)for(var u,c=r(t),f=o.f,a=0;c.length>a;)f.call(t,u=c[a++])&&n.push(u);return n}},function(t,n,r){var e=r(72),i=r(30);t.exports=function(t,n){for(var r,o=i(t),u=e(o),c=u.length,f=0;c>f;)if(o[r=u[f++]]===n)return r}},function(t,n,r){"use strict";var e=r(208),i=r(121),o=r(26);t.exports=function(){for(var t=o(this),n=arguments.length,r=Array(n),u=0,c=e._,f=!1;n>u;)(r[u]=arguments[u++])===c&&(f=!0);return function(){var e,o=this,u=arguments.length,a=0,s=0;if(!f&&!u)return i(t,r,o);if(e=r.slice(),f)for(;n>a;a++)e[a]===c&&(e[a]=arguments[s++]);for(;u>s;)e.push(arguments[s++]);return i(t,e,o)}}},function(t,n,r){t.exports=r(3)},function(t,n){t.exports=function(t,n){var r=n===Object(n)?function(t){return n[t]}:n;return function(n){return String(n).replace(t,r)}}},function(t,n,r){var e=r(1),i=r(209)(/[\\^$*+?.()|[\]{}]/g,"\\$&");e(e.S,"RegExp",{escape:function(t){return i(t)}})},function(t,n,r){var e=r(1);e(e.P,"Array",{copyWithin:r(160)}),r(78)("copyWithin")},function(t,n,r){"use strict";var e=r(1),i=r(48)(4);e(e.P+e.F*!r(47)([].every,!0),"Array",{every:function(t){return i(this,t,arguments[1])}})},function(t,n,r){var e=r(1);e(e.P,"Array",{fill:r(130)}),r(78)("fill")},function(t,n,r){"use strict";var e=r(1),i=r(48)(2);e(e.P+e.F*!r(47)([].filter,!0),"Array",{filter:function(t){return i(this,t,arguments[1])}})},function(t,n,r){"use strict";var e=r(1),i=r(48)(6),o="findIndex",u=!0;o in[]&&Array(1)[o](function(){u=!1}),e(e.P+e.F*u,"Array",{findIndex:function(t){return i(this,t,arguments.length>1?arguments[1]:void 0)}}),r(78)(o)},function(t,n,r){"use strict";var e=r(1),i=r(48)(5),o="find",u=!0;o in[]&&Array(1)[o](function(){u=!1}),e(e.P+e.F*u,"Array",{find:function(t){return i(this,t,arguments.length>1?arguments[1]:void 0)}}),r(78)(o)},function(t,n,r){"use strict";var e=r(1),i=r(48)(0),o=r(47)([].forEach,!0);e(e.P+e.F*!o,"Array",{forEach:function(t){return i(this,t,arguments[1])}})},function(t,n,r){"use strict";var e=r(53),i=r(1),o=r(17),u=r(169),c=r(137),f=r(16),a=r(131),s=r(154);i(i.S+i.F*!r(123)(function(t){Array.from(t)}),"Array",{from:function(t){var n,r,i,l,h=o(t),v="function"==typeof this?this:Array,p=arguments.length,d=p>1?arguments[1]:void 0,y=void 0!==d,g=0,b=s(h);if(y&&(d=e(d,p>2?arguments[2]:void 0,2)),void 0==b||v==Array&&c(b))for(n=f(h.length),r=new v(n);n>g;g++)a(r,g,y?d(h[g],g):h[g]);else for(l=b.call(h),r=new v;!(i=l.next()).done;g++)a(r,g,y?u(l,d,[i.value,g],!0):i.value);return r.length=g,r}})},function(t,n,r){"use strict";var e=r(1),i=r(117)(!1),o=[].indexOf,u=!!o&&1/[1].indexOf(1,-0)<0;e(e.P+e.F*(u||!r(47)(o)),"Array",{indexOf:function(t){return u?o.apply(this,arguments)||0:i(this,t,arguments[1])}})},function(t,n,r){var e=r(1);e(e.S,"Array",{isArray:r(138)})},function(t,n,r){"use strict";var e=r(1),i=r(30),o=[].join;e(e.P+e.F*(r(115)!=Object||!r(47)(o)),"Array",{join:function(t){return o.call(i(this),void 0===t?",":t)}})},function(t,n,r){"use strict";var e=r(1),i=r(30),o=r(67),u=r(16),c=[].lastIndexOf,f=!!c&&1/[1].lastIndexOf(1,-0)<0;e(e.P+e.F*(f||!r(47)(c)),"Array",{lastIndexOf:function(t){if(f)return c.apply(this,arguments)||0;var n=i(this),r=u(n.length),e=r-1;for(arguments.length>1&&(e=Math.min(e,o(arguments[1]))),e<0&&(e=r+e);e>=0;e--)if(e in n&&n[e]===t)return e||0;return-1}})},function(t,n,r){"use strict";var e=r(1),i=r(48)(1);e(e.P+e.F*!r(47)([].map,!0),"Array",{map:function(t){return i(this,t,arguments[1])}})},function(t,n,r){"use strict";var e=r(1),i=r(131);e(e.S+e.F*r(4)(function(){function t(){}return!(Array.of.call(t)instanceof t)}),"Array",{of:function(){for(var t=0,n=arguments.length,r=new("function"==typeof this?this:Array)(n);n>t;)i(r,t,arguments[t++]);return r.length=n,r}})},function(t,n,r){"use strict";var e=r(1),i=r(162);e(e.P+e.F*!r(47)([].reduceRight,!0),"Array",{reduceRight:function(t){return i(this,t,arguments.length,arguments[1],!0)}})},function(t,n,r){"use strict";var e=r(1),i=r(162);e(e.P+e.F*!r(47)([].reduce,!0),"Array",{reduce:function(t){return i(this,t,arguments.length,arguments[1],!1)}})},function(t,n,r){"use strict";var e=r(1),i=r(135),o=r(45),u=r(75),c=r(16),f=[].slice;e(e.P+e.F*r(4)(function(){i&&f.call(i)}),"Array",{slice:function(t,n){var r=c(this.length),e=o(this);if(n=void 0===n?r:n,"Array"==e)return f.call(this,t,n);for(var i=u(t,r),a=u(n,r),s=c(a-i),l=Array(s),h=0;h<s;h++)l[h]="String"==e?this.charAt(i+h):this[i+h];return l}})},function(t,n,r){"use strict";var e=r(1),i=r(48)(3);e(e.P+e.F*!r(47)([].some,!0),"Array",{some:function(t){return i(this,t,arguments[1])}})},function(t,n,r){"use strict";var e=r(1),i=r(26),o=r(17),u=r(4),c=[].sort,f=[1,2,3];e(e.P+e.F*(u(function(){f.sort(void 0)})||!u(function(){f.sort(null)})||!r(47)(c)),"Array",{sort:function(t){return void 0===t?c.call(o(this)):c.call(o(this),i(t))}})},function(t,n,r){r(74)("Array")},function(t,n,r){var e=r(1);e(e.S,"Date",{now:function(){return(new Date).getTime()}})},function(t,n,r){"use strict";var e=r(1),i=r(4),o=Date.prototype.getTime,u=function(t){return t>9?t:"0"+t};e(e.P+e.F*(i(function(){return"0385-07-25T07:06:39.999Z"!=new Date(-5e13-1).toISOString()})||!i(function(){new Date(NaN).toISOString()})),"Date",{toISOString:function(){ if(!isFinite(o.call(this)))throw RangeError("Invalid time value");var t=this,n=t.getUTCFullYear(),r=t.getUTCMilliseconds(),e=n<0?"-":n>9999?"+":"";return e+("00000"+Math.abs(n)).slice(e?-6:-4)+"-"+u(t.getUTCMonth()+1)+"-"+u(t.getUTCDate())+"T"+u(t.getUTCHours())+":"+u(t.getUTCMinutes())+":"+u(t.getUTCSeconds())+"."+(r>99?r:"0"+u(r))+"Z"}})},function(t,n,r){"use strict";var e=r(1),i=r(17),o=r(50);e(e.P+e.F*r(4)(function(){return null!==new Date(NaN).toJSON()||1!==Date.prototype.toJSON.call({toISOString:function(){return 1}})}),"Date",{toJSON:function(t){var n=i(this),r=o(n);return"number"!=typeof r||isFinite(r)?n.toISOString():null}})},function(t,n,r){var e=r(7)("toPrimitive"),i=Date.prototype;e in i||r(27)(i,e,r(204))},function(t,n,r){var e=Date.prototype,i="Invalid Date",o="toString",u=e[o],c=e.getTime;new Date(NaN)+""!=i&&r(28)(e,o,function(){var t=c.call(this);return t===t?u.call(this):i})},function(t,n,r){var e=r(1);e(e.P,"Function",{bind:r(163)})},function(t,n,r){"use strict";var e=r(6),i=r(32),o=r(7)("hasInstance"),u=Function.prototype;o in u||r(11).f(u,o,{value:function(t){if("function"!=typeof this||!e(t))return!1;if(!e(this.prototype))return t instanceof this;for(;t=i(t);)if(this.prototype===t)return!0;return!1}})},function(t,n,r){var e=r(11).f,i=r(66),o=r(24),u=Function.prototype,c="name",f=Object.isExtensible||function(){return!0};c in u||r(10)&&e(u,c,{configurable:!0,get:function(){try{var t=this,n=(""+t).match(/^\s*function ([^ (]*)/)[1];return o(t,c)||!f(t)||e(t,c,i(5,n)),n}catch(t){return""}}})},function(t,n,r){var e=r(1),i=r(171),o=Math.sqrt,u=Math.acosh;e(e.S+e.F*!(u&&710==Math.floor(u(Number.MAX_VALUE))&&u(1/0)==1/0),"Math",{acosh:function(t){return(t=+t)<1?NaN:t>94906265.62425156?Math.log(t)+Math.LN2:i(t-1+o(t-1)*o(t+1))}})},function(t,n,r){function e(t){return isFinite(t=+t)&&0!=t?t<0?-e(-t):Math.log(t+Math.sqrt(t*t+1)):t}var i=r(1),o=Math.asinh;i(i.S+i.F*!(o&&1/o(0)>0),"Math",{asinh:e})},function(t,n,r){var e=r(1),i=Math.atanh;e(e.S+e.F*!(i&&1/i(-0)<0),"Math",{atanh:function(t){return 0==(t=+t)?t:Math.log((1+t)/(1-t))/2}})},function(t,n,r){var e=r(1),i=r(142);e(e.S,"Math",{cbrt:function(t){return i(t=+t)*Math.pow(Math.abs(t),1/3)}})},function(t,n,r){var e=r(1);e(e.S,"Math",{clz32:function(t){return(t>>>=0)?31-Math.floor(Math.log(t+.5)*Math.LOG2E):32}})},function(t,n,r){var e=r(1),i=Math.exp;e(e.S,"Math",{cosh:function(t){return(i(t=+t)+i(-t))/2}})},function(t,n,r){var e=r(1),i=r(141);e(e.S+e.F*(i!=Math.expm1),"Math",{expm1:i})},function(t,n,r){var e=r(1),i=r(142),o=Math.pow,u=o(2,-52),c=o(2,-23),f=o(2,127)*(2-c),a=o(2,-126),s=function(t){return t+1/u-1/u};e(e.S,"Math",{fround:function(t){var n,r,e=Math.abs(t),o=i(t);return e<a?o*s(e/a/c)*a*c:(n=(1+c/u)*e,r=n-(n-e),r>f||r!=r?o*(1/0):o*r)}})},function(t,n,r){var e=r(1),i=Math.abs;e(e.S,"Math",{hypot:function(t,n){for(var r,e,o=0,u=0,c=arguments.length,f=0;u<c;)r=i(arguments[u++]),f<r?(e=f/r,o=o*e*e+1,f=r):r>0?(e=r/f,o+=e*e):o+=r;return f===1/0?1/0:f*Math.sqrt(o)}})},function(t,n,r){var e=r(1),i=Math.imul;e(e.S+e.F*r(4)(function(){return-5!=i(4294967295,5)||2!=i.length}),"Math",{imul:function(t,n){var r=65535,e=+t,i=+n,o=r&e,u=r&i;return 0|o*u+((r&e>>>16)*u+o*(r&i>>>16)<<16>>>0)}})},function(t,n,r){var e=r(1);e(e.S,"Math",{log10:function(t){return Math.log(t)/Math.LN10}})},function(t,n,r){var e=r(1);e(e.S,"Math",{log1p:r(171)})},function(t,n,r){var e=r(1);e(e.S,"Math",{log2:function(t){return Math.log(t)/Math.LN2}})},function(t,n,r){var e=r(1);e(e.S,"Math",{sign:r(142)})},function(t,n,r){var e=r(1),i=r(141),o=Math.exp;e(e.S+e.F*r(4)(function(){return-2e-17!=!Math.sinh(-2e-17)}),"Math",{sinh:function(t){return Math.abs(t=+t)<1?(i(t)-i(-t))/2:(o(t-1)-o(-t-1))*(Math.E/2)}})},function(t,n,r){var e=r(1),i=r(141),o=Math.exp;e(e.S,"Math",{tanh:function(t){var n=i(t=+t),r=i(-t);return n==1/0?1:r==1/0?-1:(n-r)/(o(t)+o(-t))}})},function(t,n,r){var e=r(1);e(e.S,"Math",{trunc:function(t){return(t>0?Math.floor:Math.ceil)(t)}})},function(t,n,r){"use strict";var e=r(3),i=r(24),o=r(45),u=r(136),c=r(50),f=r(4),a=r(71).f,s=r(31).f,l=r(11).f,h=r(82).trim,v="Number",p=e[v],d=p,y=p.prototype,g=o(r(70)(y))==v,b="trim"in String.prototype,m=function(t){var n=c(t,!1);if("string"==typeof n&&n.length>2){n=b?n.trim():h(n,3);var r,e,i,o=n.charCodeAt(0);if(43===o||45===o){if(88===(r=n.charCodeAt(2))||120===r)return NaN}else if(48===o){switch(n.charCodeAt(1)){case 66:case 98:e=2,i=49;break;case 79:case 111:e=8,i=55;break;default:return+n}for(var u,f=n.slice(2),a=0,s=f.length;a<s;a++)if((u=f.charCodeAt(a))<48||u>i)return NaN;return parseInt(f,e)}}return+n};if(!p(" 0o1")||!p("0b1")||p("+0x1")){p=function(t){var n=arguments.length<1?0:t,r=this;return r instanceof p&&(g?f(function(){y.valueOf.call(r)}):o(r)!=v)?u(new d(m(n)),r,p):m(n)};for(var x,w=r(10)?a(d):"MAX_VALUE,MIN_VALUE,NaN,NEGATIVE_INFINITY,POSITIVE_INFINITY,EPSILON,isFinite,isInteger,isNaN,isSafeInteger,MAX_SAFE_INTEGER,MIN_SAFE_INTEGER,parseFloat,parseInt,isInteger".split(","),S=0;w.length>S;S++)i(d,x=w[S])&&!i(p,x)&&l(p,x,s(d,x));p.prototype=y,y.constructor=p,r(28)(e,v,p)}},function(t,n,r){var e=r(1);e(e.S,"Number",{EPSILON:Math.pow(2,-52)})},function(t,n,r){var e=r(1),i=r(3).isFinite;e(e.S,"Number",{isFinite:function(t){return"number"==typeof t&&i(t)}})},function(t,n,r){var e=r(1);e(e.S,"Number",{isInteger:r(168)})},function(t,n,r){var e=r(1);e(e.S,"Number",{isNaN:function(t){return t!=t}})},function(t,n,r){var e=r(1),i=r(168),o=Math.abs;e(e.S,"Number",{isSafeInteger:function(t){return i(t)&&o(t)<=9007199254740991}})},function(t,n,r){var e=r(1);e(e.S,"Number",{MAX_SAFE_INTEGER:9007199254740991})},function(t,n,r){var e=r(1);e(e.S,"Number",{MIN_SAFE_INTEGER:-9007199254740991})},function(t,n,r){var e=r(1),i=r(178);e(e.S+e.F*(Number.parseFloat!=i),"Number",{parseFloat:i})},function(t,n,r){var e=r(1),i=r(179);e(e.S+e.F*(Number.parseInt!=i),"Number",{parseInt:i})},function(t,n,r){"use strict";var e=r(1),i=r(67),o=r(159),u=r(149),c=1..toFixed,f=Math.floor,a=[0,0,0,0,0,0],s="Number.toFixed: incorrect invocation!",l="0",h=function(t,n){for(var r=-1,e=n;++r<6;)e+=t*a[r],a[r]=e%1e7,e=f(e/1e7)},v=function(t){for(var n=6,r=0;--n>=0;)r+=a[n],a[n]=f(r/t),r=r%t*1e7},p=function(){for(var t=6,n="";--t>=0;)if(""!==n||0===t||0!==a[t]){var r=String(a[t]);n=""===n?r:n+u.call(l,7-r.length)+r}return n},d=function(t,n,r){return 0===n?r:n%2==1?d(t,n-1,r*t):d(t*t,n/2,r)},y=function(t){for(var n=0,r=t;r>=4096;)n+=12,r/=4096;for(;r>=2;)n+=1,r/=2;return n};e(e.P+e.F*(!!c&&("0.000"!==8e-5.toFixed(3)||"1"!==.9.toFixed(0)||"1.25"!==1.255.toFixed(2)||"1000000000000000128"!==(0xde0b6b3a7640080).toFixed(0))||!r(4)(function(){c.call({})})),"Number",{toFixed:function(t){var n,r,e,c,f=o(this,s),a=i(t),g="",b=l;if(a<0||a>20)throw RangeError(s);if(f!=f)return"NaN";if(f<=-1e21||f>=1e21)return String(f);if(f<0&&(g="-",f=-f),f>1e-21)if(n=y(f*d(2,69,1))-69,r=n<0?f*d(2,-n,1):f/d(2,n,1),r*=4503599627370496,(n=52-n)>0){for(h(0,r),e=a;e>=7;)h(1e7,0),e-=7;for(h(d(10,e,1),0),e=n-1;e>=23;)v(1<<23),e-=23;v(1<<e),h(1,1),v(2),b=p()}else h(0,r),h(1<<-n,0),b=p()+u.call(l,a);return a>0?(c=b.length,b=g+(c<=a?"0."+u.call(l,a-c)+b:b.slice(0,c-a)+"."+b.slice(c-a))):b=g+b,b}})},function(t,n,r){"use strict";var e=r(1),i=r(4),o=r(159),u=1..toPrecision;e(e.P+e.F*(i(function(){return"1"!==u.call(1,void 0)})||!i(function(){u.call({})})),"Number",{toPrecision:function(t){var n=o(this,"Number#toPrecision: incorrect invocation!");return void 0===t?u.call(n):u.call(n,t)}})},function(t,n,r){var e=r(1);e(e.S+e.F,"Object",{assign:r(172)})},function(t,n,r){var e=r(1);e(e.S,"Object",{create:r(70)})},function(t,n,r){var e=r(1);e(e.S+e.F*!r(10),"Object",{defineProperties:r(173)})},function(t,n,r){var e=r(1);e(e.S+e.F*!r(10),"Object",{defineProperty:r(11).f})},function(t,n,r){var e=r(6),i=r(65).onFreeze;r(49)("freeze",function(t){return function(n){return t&&e(n)?t(i(n)):n}})},function(t,n,r){var e=r(30),i=r(31).f;r(49)("getOwnPropertyDescriptor",function(){return function(t,n){return i(e(t),n)}})},function(t,n,r){r(49)("getOwnPropertyNames",function(){return r(174).f})},function(t,n,r){var e=r(17),i=r(32);r(49)("getPrototypeOf",function(){return function(t){return i(e(t))}})},function(t,n,r){var e=r(6);r(49)("isExtensible",function(t){return function(n){return!!e(n)&&(!t||t(n))}})},function(t,n,r){var e=r(6);r(49)("isFrozen",function(t){return function(n){return!e(n)||!!t&&t(n)}})},function(t,n,r){var e=r(6);r(49)("isSealed",function(t){return function(n){return!e(n)||!!t&&t(n)}})},function(t,n,r){var e=r(1);e(e.S,"Object",{is:r(180)})},function(t,n,r){var e=r(17),i=r(72);r(49)("keys",function(){return function(t){return i(e(t))}})},function(t,n,r){var e=r(6),i=r(65).onFreeze;r(49)("preventExtensions",function(t){return function(n){return t&&e(n)?t(i(n)):n}})},function(t,n,r){var e=r(6),i=r(65).onFreeze;r(49)("seal",function(t){return function(n){return t&&e(n)?t(i(n)):n}})},function(t,n,r){var e=r(1);e(e.S,"Object",{setPrototypeOf:r(144).set})},function(t,n,r){"use strict";var e=r(114),i={};i[r(7)("toStringTag")]="z",i+""!="[object z]"&&r(28)(Object.prototype,"toString",function(){return"[object "+e(this)+"]"},!0)},function(t,n,r){var e=r(1),i=r(178);e(e.G+e.F*(parseFloat!=i),{parseFloat:i})},function(t,n,r){var e=r(1),i=r(179);e(e.G+e.F*(parseInt!=i),{parseInt:i})},function(t,n,r){"use strict";var e,i,o,u=r(69),c=r(3),f=r(53),a=r(114),s=r(1),l=r(6),h=r(26),v=r(68),p=r(79),d=r(146),y=r(151).set,g=r(143)(),b="Promise",m=c.TypeError,x=c.process,w=c[b],x=c.process,S="process"==a(x),_=function(){},O=!!function(){try{var t=w.resolve(1),n=(t.constructor={})[r(7)("species")]=function(t){t(_,_)};return(S||"function"==typeof PromiseRejectionEvent)&&t.then(_)instanceof n}catch(t){}}(),E=function(t,n){return t===n||t===w&&n===o},P=function(t){var n;return!(!l(t)||"function"!=typeof(n=t.then))&&n},j=function(t){return E(w,t)?new F(t):new i(t)},F=i=function(t){var n,r;this.promise=new t(function(t,e){if(void 0!==n||void 0!==r)throw m("Bad Promise constructor");n=t,r=e}),this.resolve=h(n),this.reject=h(r)},M=function(t){try{t()}catch(t){return{error:t}}},A=function(t,n){if(!t._n){t._n=!0;var r=t._c;g(function(){for(var e=t._v,i=1==t._s,o=0;r.length>o;)!function(n){var r,o,u=i?n.ok:n.fail,c=n.resolve,f=n.reject,a=n.domain;try{u?(i||(2==t._h&&I(t),t._h=1),!0===u?r=e:(a&&a.enter(),r=u(e),a&&a.exit()),r===n.promise?f(m("Promise-chain cycle")):(o=P(r))?o.call(r,c,f):c(r)):f(e)}catch(t){f(t)}}(r[o++]);t._c=[],t._n=!1,n&&!t._h&&N(t)})}},N=function(t){y.call(c,function(){var n,r,e,i=t._v;if(T(t)&&(n=M(function(){S?x.emit("unhandledRejection",i,t):(r=c.onunhandledrejection)?r({promise:t,reason:i}):(e=c.console)&&e.error&&e.error("Unhandled promise rejection",i)}),t._h=S||T(t)?2:1),t._a=void 0,n)throw n.error})},T=function(t){if(1==t._h)return!1;for(var n,r=t._a||t._c,e=0;r.length>e;)if(n=r[e++],n.fail||!T(n.promise))return!1;return!0},I=function(t){y.call(c,function(){var n;S?x.emit("rejectionHandled",t):(n=c.onrejectionhandled)&&n({promise:t,reason:t._v})})},k=function(t){var n=this;n._d||(n._d=!0,n=n._w||n,n._v=t,n._s=2,n._a||(n._a=n._c.slice()),A(n,!0))},L=function(t){var n,r=this;if(!r._d){r._d=!0,r=r._w||r;try{if(r===t)throw m("Promise can't be resolved itself");(n=P(t))?g(function(){var e={_w:r,_d:!1};try{n.call(t,f(L,e,1),f(k,e,1))}catch(t){k.call(e,t)}}):(r._v=t,r._s=1,A(r,!1))}catch(t){k.call({_w:r,_d:!1},t)}}};O||(w=function(t){v(this,w,b,"_h"),h(t),e.call(this);try{t(f(L,this,1),f(k,this,1))}catch(t){k.call(this,t)}},e=function(t){this._c=[],this._a=void 0,this._s=0,this._d=!1,this._v=void 0,this._h=0,this._n=!1},e.prototype=r(73)(w.prototype,{then:function(t,n){var r=j(d(this,w));return r.ok="function"!=typeof t||t,r.fail="function"==typeof n&&n,r.domain=S?x.domain:void 0,this._c.push(r),this._a&&this._a.push(r),this._s&&A(this,!1),r.promise},catch:function(t){return this.then(void 0,t)}}),F=function(){var t=new e;this.promise=t,this.resolve=f(L,t,1),this.reject=f(k,t,1)}),s(s.G+s.W+s.F*!O,{Promise:w}),r(81)(w,b),r(74)(b),o=r(52)[b],s(s.S+s.F*!O,b,{reject:function(t){var n=j(this);return(0,n.reject)(t),n.promise}}),s(s.S+s.F*(u||!O),b,{resolve:function(t){if(t instanceof w&&E(t.constructor,this))return t;var n=j(this);return(0,n.resolve)(t),n.promise}}),s(s.S+s.F*!(O&&r(123)(function(t){w.all(t).catch(_)})),b,{all:function(t){var n=this,r=j(n),e=r.resolve,i=r.reject,o=M(function(){var r=[],o=0,u=1;p(t,!1,function(t){var c=o++,f=!1;r.push(void 0),u++,n.resolve(t).then(function(t){f||(f=!0,r[c]=t,--u||e(r))},i)}),--u||e(r)});return o&&i(o.error),r.promise},race:function(t){var n=this,r=j(n),e=r.reject,i=M(function(){p(t,!1,function(t){n.resolve(t).then(r.resolve,e)})});return i&&e(i.error),r.promise}})},function(t,n,r){var e=r(1),i=r(26),o=r(2),u=(r(3).Reflect||{}).apply,c=Function.apply;e(e.S+e.F*!r(4)(function(){u(function(){})}),"Reflect",{apply:function(t,n,r){var e=i(t),f=o(r);return u?u(e,n,f):c.call(e,n,f)}})},function(t,n,r){var e=r(1),i=r(70),o=r(26),u=r(2),c=r(6),f=r(4),a=r(163),s=(r(3).Reflect||{}).construct,l=f(function(){function t(){}return!(s(function(){},[],t)instanceof t)}),h=!f(function(){s(function(){})});e(e.S+e.F*(l||h),"Reflect",{construct:function(t,n){o(t),u(n);var r=arguments.length<3?t:o(arguments[2]);if(h&&!l)return s(t,n,r);if(t==r){switch(n.length){case 0:return new t;case 1:return new t(n[0]);case 2:return new t(n[0],n[1]);case 3:return new t(n[0],n[1],n[2]);case 4:return new t(n[0],n[1],n[2],n[3])}var e=[null];return e.push.apply(e,n),new(a.apply(t,e))}var f=r.prototype,v=i(c(f)?f:Object.prototype),p=Function.apply.call(t,v,n);return c(p)?p:v}})},function(t,n,r){var e=r(11),i=r(1),o=r(2),u=r(50);i(i.S+i.F*r(4)(function(){Reflect.defineProperty(e.f({},1,{value:1}),1,{value:2})}),"Reflect",{defineProperty:function(t,n,r){o(t),n=u(n,!0),o(r);try{return e.f(t,n,r),!0}catch(t){return!1}}})},function(t,n,r){var e=r(1),i=r(31).f,o=r(2);e(e.S,"Reflect",{deleteProperty:function(t,n){var r=i(o(t),n);return!(r&&!r.configurable)&&delete t[n]}})},function(t,n,r){"use strict";var e=r(1),i=r(2),o=function(t){this._t=i(t),this._i=0;var n,r=this._k=[];for(n in t)r.push(n)};r(139)(o,"Object",function(){var t,n=this,r=n._k;do{if(n._i>=r.length)return{value:void 0,done:!0}}while(!((t=r[n._i++])in n._t));return{value:t,done:!1}}),e(e.S,"Reflect",{enumerate:function(t){return new o(t)}})},function(t,n,r){var e=r(31),i=r(1),o=r(2);i(i.S,"Reflect",{getOwnPropertyDescriptor:function(t,n){return e.f(o(t),n)}})},function(t,n,r){var e=r(1),i=r(32),o=r(2);e(e.S,"Reflect",{getPrototypeOf:function(t){return i(o(t))}})},function(t,n,r){function e(t,n){var r,c,s=arguments.length<3?t:arguments[2];return a(t)===s?t[n]:(r=i.f(t,n))?u(r,"value")?r.value:void 0!==r.get?r.get.call(s):void 0:f(c=o(t))?e(c,n,s):void 0}var i=r(31),o=r(32),u=r(24),c=r(1),f=r(6),a=r(2);c(c.S,"Reflect",{get:e})},function(t,n,r){var e=r(1);e(e.S,"Reflect",{has:function(t,n){return n in t}})},function(t,n,r){var e=r(1),i=r(2),o=Object.isExtensible;e(e.S,"Reflect",{isExtensible:function(t){return i(t),!o||o(t)}})},function(t,n,r){var e=r(1);e(e.S,"Reflect",{ownKeys:r(177)})},function(t,n,r){var e=r(1),i=r(2),o=Object.preventExtensions;e(e.S,"Reflect",{preventExtensions:function(t){i(t);try{return o&&o(t),!0}catch(t){return!1}}})},function(t,n,r){var e=r(1),i=r(144);i&&e(e.S,"Reflect",{setPrototypeOf:function(t,n){i.check(t,n);try{return i.set(t,n),!0}catch(t){return!1}}})},function(t,n,r){function e(t,n,r){var f,h,v=arguments.length<4?t:arguments[3],p=o.f(s(t),n);if(!p){if(l(h=u(t)))return e(h,n,r,v);p=a(0)}return c(p,"value")?!(!1===p.writable||!l(v)||(f=o.f(v,n)||a(0),f.value=r,i.f(v,n,f),0)):void 0!==p.set&&(p.set.call(v,r),!0)}var i=r(11),o=r(31),u=r(32),c=r(24),f=r(1),a=r(66),s=r(2),l=r(6);f(f.S,"Reflect",{set:e})},function(t,n,r){var e=r(3),i=r(136),o=r(11).f,u=r(71).f,c=r(122),f=r(120),a=e.RegExp,s=a,l=a.prototype,h=/a/g,v=/a/g,p=new a(h)!==h;if(r(10)&&(!p||r(4)(function(){return v[r(7)("match")]=!1,a(h)!=h||a(v)==v||"/a/i"!=a(h,"i")}))){a=function(t,n){var r=this instanceof a,e=c(t),o=void 0===n;return!r&&e&&t.constructor===a&&o?t:i(p?new s(e&&!o?t.source:t,n):s((e=t instanceof a)?t.source:t,e&&o?f.call(t):n),r?this:l,a)};for(var d=u(s),y=0;d.length>y;)!function(t){t in a||o(a,t,{configurable:!0,get:function(){return s[t]},set:function(n){s[t]=n}})}(d[y++]);l.constructor=a,a.prototype=l,r(28)(e,"RegExp",a)}r(74)("RegExp")},function(t,n,r){r(119)("match",1,function(t,n,r){return[function(r){"use strict";var e=t(this),i=void 0==r?void 0:r[n];return void 0!==i?i.call(r,e):new RegExp(r)[n](String(e))},r]})},function(t,n,r){r(119)("replace",2,function(t,n,r){return[function(e,i){"use strict";var o=t(this),u=void 0==e?void 0:e[n];return void 0!==u?u.call(e,o,i):r.call(String(o),e,i)},r]})},function(t,n,r){r(119)("search",1,function(t,n,r){return[function(r){"use strict";var e=t(this),i=void 0==r?void 0:r[n];return void 0!==i?i.call(r,e):new RegExp(r)[n](String(e))},r]})},function(t,n,r){r(119)("split",2,function(t,n,e){"use strict";var i=r(122),o=e,u=[].push,c="split",f="length",a="lastIndex";if("c"=="abbc"[c](/(b)*/)[1]||4!="test"[c](/(?:)/,-1)[f]||2!="ab"[c](/(?:ab)*/)[f]||4!="."[c](/(.?)(.?)/)[f]||"."[c](/()()/)[f]>1||""[c](/.?/)[f]){var s=void 0===/()??/.exec("")[1];e=function(t,n){var r=String(this);if(void 0===t&&0===n)return[];if(!i(t))return o.call(r,t,n);var e,c,l,h,v,p=[],d=(t.ignoreCase?"i":"")+(t.multiline?"m":"")+(t.unicode?"u":"")+(t.sticky?"y":""),y=0,g=void 0===n?4294967295:n>>>0,b=new RegExp(t.source,d+"g");for(s||(e=new RegExp("^"+b.source+"$(?!\\s)",d));(c=b.exec(r))&&!((l=c.index+c[0][f])>y&&(p.push(r.slice(y,c.index)),!s&&c[f]>1&&c[0].replace(e,function(){for(v=1;v<arguments[f]-2;v++)void 0===arguments[v]&&(c[v]=void 0)}),c[f]>1&&c.index<r[f]&&u.apply(p,c.slice(1)),h=c[0][f],y=l,p[f]>=g));)b[a]===c.index&&b[a]++;return y===r[f]?!h&&b.test("")||p.push(""):p.push(r.slice(y)),p[f]>g?p.slice(0,g):p}}else"0"[c](void 0,0)[f]&&(e=function(t,n){return void 0===t&&0===n?[]:o.call(this,t,n)});return[function(r,i){var o=t(this),u=void 0==r?void 0:r[n];return void 0!==u?u.call(r,o,i):e.call(String(o),r,i)},e]})},function(t,n,r){"use strict";r(184);var e=r(2),i=r(120),o=r(10),u="toString",c=/./[u],f=function(t){r(28)(RegExp.prototype,u,t,!0)};r(4)(function(){return"/a/b"!=c.call({source:"a",flags:"b"})})?f(function(){var t=e(this);return"/".concat(t.source,"/","flags"in t?t.flags:!o&&t instanceof RegExp?i.call(t):void 0)}):c.name!=u&&f(function(){return c.call(this)})},function(t,n,r){"use strict";r(29)("anchor",function(t){return function(n){return t(this,"a","name",n)}})},function(t,n,r){"use strict";r(29)("big",function(t){return function(){return t(this,"big","","")}})},function(t,n,r){"use strict";r(29)("blink",function(t){return function(){return t(this,"blink","","")}})},function(t,n,r){"use strict";r(29)("bold",function(t){return function(){return t(this,"b","","")}})},function(t,n,r){"use strict";var e=r(1),i=r(147)(!1);e(e.P,"String",{codePointAt:function(t){return i(this,t)}})},function(t,n,r){"use strict";var e=r(1),i=r(16),o=r(148),u="endsWith",c=""[u];e(e.P+e.F*r(134)(u),"String",{endsWith:function(t){var n=o(this,t,u),r=arguments.length>1?arguments[1]:void 0,e=i(n.length),f=void 0===r?e:Math.min(i(r),e),a=String(t);return c?c.call(n,a,f):n.slice(f-a.length,f)===a}})},function(t,n,r){"use strict";r(29)("fixed",function(t){return function(){return t(this,"tt","","")}})},function(t,n,r){"use strict";r(29)("fontcolor",function(t){return function(n){return t(this,"font","color",n)}})},function(t,n,r){"use strict";r(29)("fontsize",function(t){return function(n){return t(this,"font","size",n)}})},function(t,n,r){var e=r(1),i=r(75),o=String.fromCharCode,u=String.fromCodePoint;e(e.S+e.F*(!!u&&1!=u.length),"String",{fromCodePoint:function(t){for(var n,r=[],e=arguments.length,u=0;e>u;){if(n=+arguments[u++],i(n,1114111)!==n)throw RangeError(n+" is not a valid code point");r.push(n<65536?o(n):o(55296+((n-=65536)>>10),n%1024+56320))}return r.join("")}})},function(t,n,r){"use strict";var e=r(1),i=r(148),o="includes";e(e.P+e.F*r(134)(o),"String",{includes:function(t){return!!~i(this,t,o).indexOf(t,arguments.length>1?arguments[1]:void 0)}})},function(t,n,r){"use strict";r(29)("italics",function(t){return function(){return t(this,"i","","")}})},function(t,n,r){"use strict";var e=r(147)(!0);r(140)(String,"String",function(t){this._t=String(t),this._i=0},function(){var t,n=this._t,r=this._i;return r>=n.length?{value:void 0,done:!0}:(t=e(n,r),this._i+=t.length,{value:t,done:!1})})},function(t,n,r){"use strict";r(29)("link",function(t){return function(n){return t(this,"a","href",n)}})},function(t,n,r){var e=r(1),i=r(30),o=r(16);e(e.S,"String",{raw:function(t){for(var n=i(t.raw),r=o(n.length),e=arguments.length,u=[],c=0;r>c;)u.push(String(n[c++])),c<e&&u.push(String(arguments[c]));return u.join("")}})},function(t,n,r){var e=r(1);e(e.P,"String",{repeat:r(149)})},function(t,n,r){"use strict";r(29)("small",function(t){return function(){return t(this,"small","","")}})},function(t,n,r){"use strict";var e=r(1),i=r(16),o=r(148),u="startsWith",c=""[u];e(e.P+e.F*r(134)(u),"String",{startsWith:function(t){var n=o(this,t,u),r=i(Math.min(arguments.length>1?arguments[1]:void 0,n.length)),e=String(t);return c?c.call(n,e,r):n.slice(r,r+e.length)===e}})},function(t,n,r){"use strict";r(29)("strike",function(t){return function(){return t(this,"strike","","")}})},function(t,n,r){"use strict";r(29)("sub",function(t){return function(){return t(this,"sub","","")}})},function(t,n,r){"use strict";r(29)("sup",function(t){return function(){return t(this,"sup","","")}})},function(t,n,r){"use strict";r(82)("trim",function(t){return function(){return t(this,3)}})},function(t,n,r){"use strict";var e=r(3),i=r(24),o=r(10),u=r(1),c=r(28),f=r(65).KEY,a=r(4),s=r(126),l=r(81),h=r(76),v=r(7),p=r(182),d=r(153),y=r(206),g=r(205),b=r(138),m=r(2),x=r(30),w=r(50),S=r(66),_=r(70),O=r(174),E=r(31),P=r(11),j=r(72),F=E.f,M=P.f,A=O.f,N=e.Symbol,T=e.JSON,I=T&&T.stringify,k="prototype",L=v("_hidden"),R=v("toPrimitive"),C={}.propertyIsEnumerable,D=s("symbol-registry"),U=s("symbols"),W=s("op-symbols"),G=Object[k],B="function"==typeof N,V=e.QObject,z=!V||!V[k]||!V[k].findChild,q=o&&a(function(){return 7!=_(M({},"a",{get:function(){return M(this,"a",{value:7}).a}})).a})?function(t,n,r){var e=F(G,n);e&&delete G[n],M(t,n,r),e&&t!==G&&M(G,n,e)}:M,K=function(t){var n=U[t]=_(N[k]);return n._k=t,n},J=B&&"symbol"==typeof N.iterator?function(t){return"symbol"==typeof t}:function(t){return t instanceof N},Y=function(t,n,r){return t===G&&Y(W,n,r),m(t),n=w(n,!0),m(r),i(U,n)?(r.enumerable?(i(t,L)&&t[L][n]&&(t[L][n]=!1),r=_(r,{enumerable:S(0,!1)})):(i(t,L)||M(t,L,S(1,{})),t[L][n]=!0),q(t,n,r)):M(t,n,r)},H=function(t,n){m(t);for(var r,e=g(n=x(n)),i=0,o=e.length;o>i;)Y(t,r=e[i++],n[r]);return t},$=function(t,n){return void 0===n?_(t):H(_(t),n)},X=function(t){var n=C.call(this,t=w(t,!0));return!(this===G&&i(U,t)&&!i(W,t))&&(!(n||!i(this,t)||!i(U,t)||i(this,L)&&this[L][t])||n)},Q=function(t,n){if(t=x(t),n=w(n,!0),t!==G||!i(U,n)||i(W,n)){var r=F(t,n);return!r||!i(U,n)||i(t,L)&&t[L][n]||(r.enumerable=!0),r}},Z=function(t){for(var n,r=A(x(t)),e=[],o=0;r.length>o;)i(U,n=r[o++])||n==L||n==f||e.push(n);return e},tt=function(t){for(var n,r=t===G,e=A(r?W:x(t)),o=[],u=0;e.length>u;)!i(U,n=e[u++])||r&&!i(G,n)||o.push(U[n]);return o};B||(N=function(){if(this instanceof N)throw TypeError("Symbol is not a constructor!");var t=h(arguments.length>0?arguments[0]:void 0),n=function(r){this===G&&n.call(W,r),i(this,L)&&i(this[L],t)&&(this[L][t]=!1),q(this,t,S(1,r))};return o&&z&&q(G,t,{configurable:!0,set:n}),K(t)},c(N[k],"toString",function(){return this._k}),E.f=Q,P.f=Y,r(71).f=O.f=Z,r(116).f=X,r(125).f=tt,o&&!r(69)&&c(G,"propertyIsEnumerable",X,!0),p.f=function(t){return K(v(t))}),u(u.G+u.W+u.F*!B,{Symbol:N});for(var nt="hasInstance,isConcatSpreadable,iterator,match,replace,search,species,split,toPrimitive,toStringTag,unscopables".split(","),rt=0;nt.length>rt;)v(nt[rt++]);for(var nt=j(v.store),rt=0;nt.length>rt;)d(nt[rt++]);u(u.S+u.F*!B,"Symbol",{for:function(t){return i(D,t+="")?D[t]:D[t]=N(t)},keyFor:function(t){if(J(t))return y(D,t);throw TypeError(t+" is not a symbol!")},useSetter:function(){z=!0},useSimple:function(){z=!1}}),u(u.S+u.F*!B,"Object",{create:$,defineProperty:Y,defineProperties:H,getOwnPropertyDescriptor:Q,getOwnPropertyNames:Z,getOwnPropertySymbols:tt}),T&&u(u.S+u.F*(!B||a(function(){var t=N();return"[null]"!=I([t])||"{}"!=I({a:t})||"{}"!=I(Object(t))})),"JSON",{stringify:function(t){if(void 0!==t&&!J(t)){for(var n,r,e=[t],i=1;arguments.length>i;)e.push(arguments[i++]);return n=e[1],"function"==typeof n&&(r=n),!r&&b(n)||(n=function(t,n){if(r&&(n=r.call(this,t,n)),!J(n))return n}),e[1]=n,I.apply(T,e)}}}),N[k][R]||r(27)(N[k],R,N[k].valueOf),l(N,"Symbol"),l(Math,"Math",!0),l(e.JSON,"JSON",!0)},function(t,n,r){"use strict";var e=r(1),i=r(127),o=r(152),u=r(2),c=r(75),f=r(16),a=r(6),s=r(3).ArrayBuffer,l=r(146),h=o.ArrayBuffer,v=o.DataView,p=i.ABV&&s.isView,d=h.prototype.slice,y=i.VIEW,g="ArrayBuffer";e(e.G+e.W+e.F*(s!==h),{ArrayBuffer:h}),e(e.S+e.F*!i.CONSTR,g,{isView:function(t){return p&&p(t)||a(t)&&y in t}}),e(e.P+e.U+e.F*r(4)(function(){return!new h(2).slice(1,void 0).byteLength}),g,{slice:function(t,n){if(void 0!==d&&void 0===n)return d.call(u(this),t);for(var r=u(this).byteLength,e=c(t,r),i=c(void 0===n?r:n,r),o=new(l(this,h))(f(i-e)),a=new v(this),s=new v(o),p=0;e<i;)s.setUint8(p++,a.getUint8(e++));return o}}),r(74)(g)},function(t,n,r){var e=r(1);e(e.G+e.W+e.F*!r(127).ABV,{DataView:r(152).DataView})},function(t,n,r){r(55)("Float32",4,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Float64",8,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Int16",2,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Int32",4,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Int8",1,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Uint16",2,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Uint32",4,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Uint8",1,function(t){return function(n,r,e){return t(this,n,r,e)}})},function(t,n,r){r(55)("Uint8",1,function(t){return function(n,r,e){return t(this,n,r,e)}},!0)},function(t,n,r){"use strict";var e=r(166);r(118)("WeakSet",function(t){return function(){return t(this,arguments.length>0?arguments[0]:void 0)}},{add:function(t){return e.def(this,t,!0)}},e,!1,!0)},function(t,n,r){"use strict";var e=r(1),i=r(117)(!0);e(e.P,"Array",{includes:function(t){return i(this,t,arguments.length>1?arguments[1]:void 0)}}),r(78)("includes")},function(t,n,r){var e=r(1),i=r(143)(),o=r(3).process,u="process"==r(45)(o);e(e.G,{asap:function(t){var n=u&&o.domain;i(n?n.bind(t):t)}})},function(t,n,r){var e=r(1),i=r(45);e(e.S,"Error",{isError:function(t){return"Error"===i(t)}})},function(t,n,r){var e=r(1);e(e.P+e.R,"Map",{toJSON:r(165)("Map")})},function(t,n,r){var e=r(1);e(e.S,"Math",{iaddh:function(t,n,r,e){var i=t>>>0,o=n>>>0,u=r>>>0;return o+(e>>>0)+((i&u|(i|u)&~(i+u>>>0))>>>31)|0}})},function(t,n,r){var e=r(1);e(e.S,"Math",{imulh:function(t,n){var r=65535,e=+t,i=+n,o=e&r,u=i&r,c=e>>16,f=i>>16,a=(c*u>>>0)+(o*u>>>16);return c*f+(a>>16)+((o*f>>>0)+(a&r)>>16)}})},function(t,n,r){var e=r(1);e(e.S,"Math",{isubh:function(t,n,r,e){var i=t>>>0,o=n>>>0,u=r>>>0;return o-(e>>>0)-((~i&u|~(i^u)&i-u>>>0)>>>31)|0}})},function(t,n,r){var e=r(1);e(e.S,"Math",{umulh:function(t,n){var r=65535,e=+t,i=+n,o=e&r,u=i&r,c=e>>>16,f=i>>>16,a=(c*u>>>0)+(o*u>>>16);return c*f+(a>>>16)+((o*f>>>0)+(a&r)>>>16)}})},function(t,n,r){"use strict";var e=r(1),i=r(17),o=r(26),u=r(11);r(10)&&e(e.P+r(124),"Object",{__defineGetter__:function(t,n){u.f(i(this),t,{get:o(n),enumerable:!0,configurable:!0})}})},function(t,n,r){"use strict";var e=r(1),i=r(17),o=r(26),u=r(11);r(10)&&e(e.P+r(124),"Object",{__defineSetter__:function(t,n){u.f(i(this),t,{set:o(n),enumerable:!0,configurable:!0})}})},function(t,n,r){var e=r(1),i=r(176)(!0);e(e.S,"Object",{entries:function(t){return i(t)}})},function(t,n,r){var e=r(1),i=r(177),o=r(30),u=r(31),c=r(131);e(e.S,"Object",{getOwnPropertyDescriptors:function(t){for(var n,r=o(t),e=u.f,f=i(r),a={},s=0;f.length>s;)c(a,n=f[s++],e(r,n));return a}})},function(t,n,r){"use strict";var e=r(1),i=r(17),o=r(50),u=r(32),c=r(31).f;r(10)&&e(e.P+r(124),"Object",{__lookupGetter__:function(t){var n,r=i(this),e=o(t,!0);do{if(n=c(r,e))return n.get}while(r=u(r))}})},function(t,n,r){"use strict";var e=r(1),i=r(17),o=r(50),u=r(32),c=r(31).f;r(10)&&e(e.P+r(124),"Object",{__lookupSetter__:function(t){var n,r=i(this),e=o(t,!0);do{if(n=c(r,e))return n.set}while(r=u(r))}})},function(t,n,r){var e=r(1),i=r(176)(!1);e(e.S,"Object",{values:function(t){return i(t)}})},function(t,n,r){"use strict";var e=r(1),i=r(3),o=r(52),u=r(143)(),c=r(7)("observable"),f=r(26),a=r(2),s=r(68),l=r(73),h=r(27),v=r(79),p=v.RETURN,d=function(t){return null==t?void 0:f(t)},y=function(t){var n=t._c;n&&(t._c=void 0,n())},g=function(t){return void 0===t._o},b=function(t){g(t)||(t._o=void 0,y(t))},m=function(t,n){a(t),this._c=void 0,this._o=t,t=new x(this);try{var r=n(t),e=r;null!=r&&("function"==typeof r.unsubscribe?r=function(){e.unsubscribe()}:f(r),this._c=r)}catch(n){return void t.error(n)}g(this)&&y(this)};m.prototype=l({},{unsubscribe:function(){b(this)}});var x=function(t){this._s=t};x.prototype=l({},{next:function(t){var n=this._s;if(!g(n)){var r=n._o;try{var e=d(r.next);if(e)return e.call(r,t)}catch(t){try{b(n)}finally{throw t}}}},error:function(t){var n=this._s;if(g(n))throw t;var r=n._o;n._o=void 0;try{var e=d(r.error);if(!e)throw t;t=e.call(r,t)}catch(t){try{y(n)}finally{throw t}}return y(n),t},complete:function(t){var n=this._s;if(!g(n)){var r=n._o;n._o=void 0;try{var e=d(r.complete);t=e?e.call(r,t):void 0}catch(t){try{y(n)}finally{throw t}}return y(n),t}}});var w=function(t){s(this,w,"Observable","_f")._f=f(t)};l(w.prototype,{subscribe:function(t){return new m(t,this._f)},forEach:function(t){var n=this;return new(o.Promise||i.Promise)(function(r,e){f(t);var i=n.subscribe({next:function(n){try{return t(n)}catch(t){e(t),i.unsubscribe()}},error:e,complete:r})})}}),l(w,{from:function(t){var n="function"==typeof this?this:w,r=d(a(t)[c]);if(r){var e=a(r.call(t));return e.constructor===n?e:new n(function(t){return e.subscribe(t)})}return new n(function(n){var r=!1;return u(function(){if(!r){try{if(v(t,!1,function(t){if(n.next(t),r)return p})===p)return}catch(t){if(r)throw t;return void n.error(t)}n.complete()}}),function(){r=!0}})},of:function(){for(var t=0,n=arguments.length,r=Array(n);t<n;)r[t]=arguments[t++];return new("function"==typeof this?this:w)(function(t){var n=!1;return u(function(){if(!n){for(var e=0;e<r.length;++e)if(t.next(r[e]),n)return;t.complete()}}),function(){n=!0}})}}),h(w.prototype,c,function(){return this}),e(e.G,{Observable:w}),r(74)("Observable")},function(t,n,r){var e=r(54),i=r(2),o=e.key,u=e.set;e.exp({defineMetadata:function(t,n,r,e){u(t,n,i(r),o(e))}})},function(t,n,r){var e=r(54),i=r(2),o=e.key,u=e.map,c=e.store;e.exp({deleteMetadata:function(t,n){var r=arguments.length<3?void 0:o(arguments[2]),e=u(i(n),r,!1);if(void 0===e||!e.delete(t))return!1;if(e.size)return!0;var f=c.get(n);return f.delete(r),!!f.size||c.delete(n)}})},function(t,n,r){var e=r(185),i=r(161),o=r(54),u=r(2),c=r(32),f=o.keys,a=o.key,s=function(t,n){var r=f(t,n),o=c(t);if(null===o)return r;var u=s(o,n);return u.length?r.length?i(new e(r.concat(u))):u:r};o.exp({getMetadataKeys:function(t){return s(u(t),arguments.length<2?void 0:a(arguments[1]))}})},function(t,n,r){var e=r(54),i=r(2),o=r(32),u=e.has,c=e.get,f=e.key,a=function(t,n,r){if(u(t,n,r))return c(t,n,r);var e=o(n);return null!==e?a(t,e,r):void 0};e.exp({getMetadata:function(t,n){return a(t,i(n),arguments.length<3?void 0:f(arguments[2]))}})},function(t,n,r){var e=r(54),i=r(2),o=e.keys,u=e.key;e.exp({getOwnMetadataKeys:function(t){ return o(i(t),arguments.length<2?void 0:u(arguments[1]))}})},function(t,n,r){var e=r(54),i=r(2),o=e.get,u=e.key;e.exp({getOwnMetadata:function(t,n){return o(t,i(n),arguments.length<3?void 0:u(arguments[2]))}})},function(t,n,r){var e=r(54),i=r(2),o=r(32),u=e.has,c=e.key,f=function(t,n,r){if(u(t,n,r))return!0;var e=o(n);return null!==e&&f(t,e,r)};e.exp({hasMetadata:function(t,n){return f(t,i(n),arguments.length<3?void 0:c(arguments[2]))}})},function(t,n,r){var e=r(54),i=r(2),o=e.has,u=e.key;e.exp({hasOwnMetadata:function(t,n){return o(t,i(n),arguments.length<3?void 0:u(arguments[2]))}})},function(t,n,r){var e=r(54),i=r(2),o=r(26),u=e.key,c=e.set;e.exp({metadata:function(t,n){return function(r,e){c(t,n,(void 0!==e?i:o)(r),u(e))}}})},function(t,n,r){var e=r(1);e(e.P+e.R,"Set",{toJSON:r(165)("Set")})},function(t,n,r){"use strict";var e=r(1),i=r(147)(!0);e(e.P,"String",{at:function(t){return i(this,t)}})},function(t,n,r){"use strict";var e=r(1),i=r(46),o=r(16),u=r(122),c=r(120),f=RegExp.prototype,a=function(t,n){this._r=t,this._s=n};r(139)(a,"RegExp String",function(){var t=this._r.exec(this._s);return{value:t,done:null===t}}),e(e.P,"String",{matchAll:function(t){if(i(this),!u(t))throw TypeError(t+" is not a regexp!");var n=String(this),r="flags"in f?String(t.flags):c.call(t),e=new RegExp(t.source,~r.indexOf("g")?r:"g"+r);return e.lastIndex=o(t.lastIndex),new a(e,n)}})},function(t,n,r){"use strict";var e=r(1),i=r(181);e(e.P,"String",{padEnd:function(t){return i(this,t,arguments.length>1?arguments[1]:void 0,!1)}})},function(t,n,r){"use strict";var e=r(1),i=r(181);e(e.P,"String",{padStart:function(t){return i(this,t,arguments.length>1?arguments[1]:void 0,!0)}})},function(t,n,r){"use strict";r(82)("trimLeft",function(t){return function(){return t(this,1)}},"trimStart")},function(t,n,r){"use strict";r(82)("trimRight",function(t){return function(){return t(this,2)}},"trimEnd")},function(t,n,r){r(153)("asyncIterator")},function(t,n,r){r(153)("observable")},function(t,n,r){var e=r(1);e(e.S,"System",{global:r(3)})},function(t,n,r){for(var e=r(155),i=r(28),o=r(3),u=r(27),c=r(80),f=r(7),a=f("iterator"),s=f("toStringTag"),l=c.Array,h=["NodeList","DOMTokenList","MediaList","StyleSheetList","CSSRuleList"],v=0;v<5;v++){var p,d=h[v],y=o[d],g=y&&y.prototype;if(g){g[a]||u(g,a,l),g[s]||u(g,s,d),c[d]=l;for(p in e)g[p]||i(g,p,e[p],!0)}}},function(t,n,r){var e=r(1),i=r(151);e(e.G+e.B,{setImmediate:i.set,clearImmediate:i.clear})},function(t,n,r){var e=r(3),i=r(1),o=r(121),u=r(207),c=e.navigator,f=!!c&&/MSIE .\./.test(c.userAgent),a=function(t){return f?function(n,r){return t(o(u,[].slice.call(arguments,2),"function"==typeof n?n:Function(n)),r)}:t};i(i.G+i.B+i.F*f,{setTimeout:a(e.setTimeout),setInterval:a(e.setInterval)})},function(t,n,r){r(330),r(269),r(271),r(270),r(273),r(275),r(280),r(274),r(272),r(282),r(281),r(277),r(278),r(276),r(268),r(279),r(283),r(284),r(236),r(238),r(237),r(286),r(285),r(256),r(266),r(267),r(257),r(258),r(259),r(260),r(261),r(262),r(263),r(264),r(265),r(239),r(240),r(241),r(242),r(243),r(244),r(245),r(246),r(247),r(248),r(249),r(250),r(251),r(252),r(253),r(254),r(255),r(317),r(322),r(329),r(320),r(312),r(313),r(318),r(323),r(325),r(308),r(309),r(310),r(311),r(314),r(315),r(316),r(319),r(321),r(324),r(326),r(327),r(328),r(231),r(233),r(232),r(235),r(234),r(220),r(218),r(224),r(221),r(227),r(229),r(217),r(223),r(214),r(228),r(212),r(226),r(225),r(219),r(222),r(211),r(213),r(216),r(215),r(230),r(155),r(302),r(307),r(184),r(303),r(304),r(305),r(306),r(287),r(183),r(185),r(186),r(342),r(331),r(332),r(337),r(340),r(341),r(335),r(338),r(336),r(339),r(333),r(334),r(288),r(289),r(290),r(291),r(292),r(295),r(293),r(294),r(296),r(297),r(298),r(299),r(301),r(300),r(343),r(369),r(372),r(371),r(373),r(374),r(370),r(375),r(376),r(354),r(357),r(353),r(351),r(352),r(355),r(356),r(346),r(368),r(377),r(345),r(347),r(349),r(348),r(350),r(359),r(360),r(362),r(361),r(364),r(363),r(365),r(366),r(367),r(344),r(358),r(380),r(379),r(378),t.exports=r(52)},function(t,n){function r(t,n){if("string"==typeof n)return t.insertAdjacentHTML("afterend",n);var r=t.nextSibling;return r?t.parentNode.insertBefore(n,r):t.parentNode.appendChild(n)}t.exports=r},,,,,,,,,function(t,n,r){(function(n,r){!function(n){"use strict";function e(t,n,r,e){var i=n&&n.prototype instanceof o?n:o,u=Object.create(i.prototype),c=new p(e||[]);return u._invoke=s(t,r,c),u}function i(t,n,r){try{return{type:"normal",arg:t.call(n,r)}}catch(t){return{type:"throw",arg:t}}}function o(){}function u(){}function c(){}function f(t){["next","throw","return"].forEach(function(n){t[n]=function(t){return this._invoke(n,t)}})}function a(t){function n(r,e,o,u){var c=i(t[r],t,e);if("throw"!==c.type){var f=c.arg,a=f.value;return a&&"object"==typeof a&&m.call(a,"__await")?Promise.resolve(a.__await).then(function(t){n("next",t,o,u)},function(t){n("throw",t,o,u)}):Promise.resolve(a).then(function(t){f.value=t,o(f)},u)}u(c.arg)}function e(t,r){function e(){return new Promise(function(e,i){n(t,r,e,i)})}return o=o?o.then(e,e):e()}"object"==typeof r&&r.domain&&(n=r.domain.bind(n));var o;this._invoke=e}function s(t,n,r){var e=P;return function(o,u){if(e===F)throw new Error("Generator is already running");if(e===M){if("throw"===o)throw u;return y()}for(r.method=o,r.arg=u;;){var c=r.delegate;if(c){var f=l(c,r);if(f){if(f===A)continue;return f}}if("next"===r.method)r.sent=r._sent=r.arg;else if("throw"===r.method){if(e===P)throw e=M,r.arg;r.dispatchException(r.arg)}else"return"===r.method&&r.abrupt("return",r.arg);e=F;var a=i(t,n,r);if("normal"===a.type){if(e=r.done?M:j,a.arg===A)continue;return{value:a.arg,done:r.done}}"throw"===a.type&&(e=M,r.method="throw",r.arg=a.arg)}}}function l(t,n){var r=t.iterator[n.method];if(r===g){if(n.delegate=null,"throw"===n.method){if(t.iterator.return&&(n.method="return",n.arg=g,l(t,n),"throw"===n.method))return A;n.method="throw",n.arg=new TypeError("The iterator does not provide a 'throw' method")}return A}var e=i(r,t.iterator,n.arg);if("throw"===e.type)return n.method="throw",n.arg=e.arg,n.delegate=null,A;var o=e.arg;return o?o.done?(n[t.resultName]=o.value,n.next=t.nextLoc,"return"!==n.method&&(n.method="next",n.arg=g),n.delegate=null,A):o:(n.method="throw",n.arg=new TypeError("iterator result is not an object"),n.delegate=null,A)}function h(t){var n={tryLoc:t[0]};1 in t&&(n.catchLoc=t[1]),2 in t&&(n.finallyLoc=t[2],n.afterLoc=t[3]),this.tryEntries.push(n)}function v(t){var n=t.completion||{};n.type="normal",delete n.arg,t.completion=n}function p(t){this.tryEntries=[{tryLoc:"root"}],t.forEach(h,this),this.reset(!0)}function d(t){if(t){var n=t[w];if(n)return n.call(t);if("function"==typeof t.next)return t;if(!isNaN(t.length)){var r=-1,e=function n(){for(;++r<t.length;)if(m.call(t,r))return n.value=t[r],n.done=!1,n;return n.value=g,n.done=!0,n};return e.next=e}}return{next:y}}function y(){return{value:g,done:!0}}var g,b=Object.prototype,m=b.hasOwnProperty,x="function"==typeof Symbol?Symbol:{},w=x.iterator||"@@iterator",S=x.asyncIterator||"@@asyncIterator",_=x.toStringTag||"@@toStringTag",O="object"==typeof t,E=n.regeneratorRuntime;if(E)return void(O&&(t.exports=E));E=n.regeneratorRuntime=O?t.exports:{},E.wrap=e;var P="suspendedStart",j="suspendedYield",F="executing",M="completed",A={},N={};N[w]=function(){return this};var T=Object.getPrototypeOf,I=T&&T(T(d([])));I&&I!==b&&m.call(I,w)&&(N=I);var k=c.prototype=o.prototype=Object.create(N);u.prototype=k.constructor=c,c.constructor=u,c[_]=u.displayName="GeneratorFunction",E.isGeneratorFunction=function(t){var n="function"==typeof t&&t.constructor;return!!n&&(n===u||"GeneratorFunction"===(n.displayName||n.name))},E.mark=function(t){return Object.setPrototypeOf?Object.setPrototypeOf(t,c):(t.__proto__=c,_ in t||(t[_]="GeneratorFunction")),t.prototype=Object.create(k),t},E.awrap=function(t){return{__await:t}},f(a.prototype),a.prototype[S]=function(){return this},E.AsyncIterator=a,E.async=function(t,n,r,i){var o=new a(e(t,n,r,i));return E.isGeneratorFunction(n)?o:o.next().then(function(t){return t.done?t.value:o.next()})},f(k),k[_]="Generator",k.toString=function(){return"[object Generator]"},E.keys=function(t){var n=[];for(var r in t)n.push(r);return n.reverse(),function r(){for(;n.length;){var e=n.pop();if(e in t)return r.value=e,r.done=!1,r}return r.done=!0,r}},E.values=d,p.prototype={constructor:p,reset:function(t){if(this.prev=0,this.next=0,this.sent=this._sent=g,this.done=!1,this.delegate=null,this.method="next",this.arg=g,this.tryEntries.forEach(v),!t)for(var n in this)"t"===n.charAt(0)&&m.call(this,n)&&!isNaN(+n.slice(1))&&(this[n]=g)},stop:function(){this.done=!0;var t=this.tryEntries[0],n=t.completion;if("throw"===n.type)throw n.arg;return this.rval},dispatchException:function(t){function n(n,e){return o.type="throw",o.arg=t,r.next=n,e&&(r.method="next",r.arg=g),!!e}if(this.done)throw t;for(var r=this,e=this.tryEntries.length-1;e>=0;--e){var i=this.tryEntries[e],o=i.completion;if("root"===i.tryLoc)return n("end");if(i.tryLoc<=this.prev){var u=m.call(i,"catchLoc"),c=m.call(i,"finallyLoc");if(u&&c){if(this.prev<i.catchLoc)return n(i.catchLoc,!0);if(this.prev<i.finallyLoc)return n(i.finallyLoc)}else if(u){if(this.prev<i.catchLoc)return n(i.catchLoc,!0)}else{if(!c)throw new Error("try statement without catch or finally");if(this.prev<i.finallyLoc)return n(i.finallyLoc)}}}},abrupt:function(t,n){for(var r=this.tryEntries.length-1;r>=0;--r){var e=this.tryEntries[r];if(e.tryLoc<=this.prev&&m.call(e,"finallyLoc")&&this.prev<e.finallyLoc){var i=e;break}}i&&("break"===t||"continue"===t)&&i.tryLoc<=n&&n<=i.finallyLoc&&(i=null);var o=i?i.completion:{};return o.type=t,o.arg=n,i?(this.method="next",this.next=i.finallyLoc,A):this.complete(o)},complete:function(t,n){if("throw"===t.type)throw t.arg;return"break"===t.type||"continue"===t.type?this.next=t.arg:"return"===t.type?(this.rval=this.arg=t.arg,this.method="return",this.next="end"):"normal"===t.type&&n&&(this.next=n),A},finish:function(t){for(var n=this.tryEntries.length-1;n>=0;--n){var r=this.tryEntries[n];if(r.finallyLoc===t)return this.complete(r.completion,r.afterLoc),v(r),A}},catch:function(t){for(var n=this.tryEntries.length-1;n>=0;--n){var r=this.tryEntries[n];if(r.tryLoc===t){var e=r.completion;if("throw"===e.type){var i=e.arg;v(r)}return i}}throw new Error("illegal catch attempt")},delegateYield:function(t,n,r){return this.delegate={iterator:d(t),resultName:n,nextLoc:r},"next"===this.method&&(this.arg=g),A}}}("object"==typeof n?n:"object"==typeof window?window:"object"==typeof self?self:this)}).call(n,function(){return this}(),r(158))}])</script><script src="/./main.0cf68a.js"></script><script>!function(){!function(e){var t=document.createElement("script");document.getElementsByTagName("body")[0].appendChild(t),t.setAttribute("src",e)}("/slider.e37972.js")}()</script> <div class="tools-col" q-class="show:isShow,hide:isShow|isFalse" q-on="click:stop(e)"> <div class="tools-nav header-menu"> <ul style="width: 70%"> <li style="width: 33.333333333333336%" q-on="click: openSlider(e, 'innerArchive')"><a href="javascript:void(0)" q-class="active:innerArchive">所有文章</a></li> <li style="width: 33.333333333333336%" q-on="click: openSlider(e, 'friends')"><a href="javascript:void(0)" q-class="active:friends">友链</a></li> <li style="width: 33.333333333333336%" q-on="click: openSlider(e, 'aboutme')"><a href="javascript:void(0)" q-class="active:aboutme">关于我</a></li> </ul> </div> <div class="tools-wrap"> <section class="tools-section tools-section-all" q-show="innerArchive"> <div class="search-wrap"> <input class="search-ipt" q-model="search" type="text" placeholder="find something…"> <i class="icon-search icon" q-show="search|isEmptyStr"></i> <i class="icon-close icon" q-show="search|isNotEmptyStr" q-on="click:clearChose(e)"></i> </div> <div class="widget tagcloud search-tag"> <p class="search-tag-wording">tag:</p> <label class="search-switch"> <input type="checkbox" q-on="click:toggleTag(e)" q-attr="checked:showTags"> </label> <ul class="article-tag-list" q-show="showTags"> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">jekyll</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">jekyll RubyGems</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">BootStrap HTML CSS Zhihu</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">Sublime jshint csslint</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">JavaScript Array 算法 慕课网</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">GitHub 同步 fork</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">Baidu ife HTML CSS task</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">tools CSS reveal 配色</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">Baidu ife JavaScript 正则 Regular</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">JavaScript 作用域 慕课网 ife</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">面试 Lenovo 实习 JavaScript</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">JavaScript 函数 慕课网 ife</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">JavaScript 慕课网 this ife</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">JavaScript 闭包 慕课网 ife</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">JavaScript 面向对象 慕课网 ife</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">JavaScript HTML CSS Sass 移动端 XSS AMD requireJS CommonJS 性能优化 WebApp</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">Weinre WebApp 调试工具 JavaScript HTML CSS</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">JavaScript HTML CSS 思维导图 技能树</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">IE CSS 兼容性 HTML</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">JavaScript Ajax URL HistoryApi pushState pjax</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">jekyll 端口 markdown Foxit RubyGems HTML CSS</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">正则 分组 Regular</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">对象 函数 this 闭包 面向对象 作用域</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">继承 对象 原型 Array 正则</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">函数 JavaScript</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">ES2015 ES6 ES5 babel</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">Git GitHub 分支</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">算法 shuffle 乱序 洗牌</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">文件 下载 JavaScript</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">countdown JavaScript</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">hexo JavaScript</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">scrapy 爬虫</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">scrapy_redis 爬虫</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">Ubuntu Pycharm</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">win10 工具软件</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">linux ubuntu16.04 工具软件</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">MongoDB Redis 工具软件</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">centos7 crontab linux 工具软件</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">私密</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">windows vc 应用</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">qt socket exe</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">qt QSharedMemory 共享</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">qt QPattle 类</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">qt QProcess exe</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">u8</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">R</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">HarmonyOS</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">ArkTS</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">DevEco Studio</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">认证考试</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">CPP</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">NDK</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">练习题</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color1">windows python saprk 工具软件</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">windows tcp udp 网络</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color4">下雪了</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color3">你好</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">hexo</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color2">windows api</a> </li> <li class="article-tag-list-item"> <a href="javascript:void(0)" class="js-tag color5">项目展示</a> </li> <div class="clearfix"></div> </ul> </div> <ul class="search-ul"> <p q-show="jsonFail" style="padding: 20px; font-size: 12px;"> 缺失模块。<br/>1、请确保node版本大于6.2<br/>2、在博客根目录(注意不是yilia根目录)执行以下命令:<br/> npm i hexo-generator-json-content --save<br/><br/> 3、在根目录_config.yml里添加配置: <pre style="font-size: 12px;" q-show="jsonFail"> jsonContent: meta: false pages: false posts: title: true date: true path: true text: false raw: false content: false slug: false updated: false comments: false link: false permalink: false excerpt: false categories: false tags: true </pre> </p> <li class="search-li" q-repeat="items" q-show="isShow"> <a q-attr="href:path|urlformat" class="search-title"><i class="icon-quo-left icon"></i><span q-text="title"></span></a> <p class="search-time"> <i class="icon-calendar icon"></i> <span q-text="date|dateformat"></span> </p> <p class="search-tag"> <i class="icon-price-tags icon"></i> <span q-repeat="tags" q-on="click:choseTag(e, name)" q-text="name|tagformat"></span> </p> </li> </ul> </section> <section class="tools-section tools-section-friends" q-show="friends"> <ul class="search-ul"> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接1</a> </li> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接2</a> </li> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接3</a> </li> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接4</a> </li> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接5</a> </li> <li class="search-li"> <a href="http://localhost:4000/" target="_blank" class="search-title"><i class="icon-quo-left icon"></i>友情链接6</a> </li> </ul> </section> <section class="tools-section tools-section-me" q-show="aboutme"> <div class="aboutme-wrap" id="js-aboutme">很惭愧<br><br>只做了一点微小的工作<br>谢谢大家</div> </section> </div> </div> <!-- Root element of PhotoSwipe. Must have class pswp. --> <div class="pswp" tabindex="-1" role="dialog" aria-hidden="true"> <!-- Background of PhotoSwipe. It's a separate element as animating opacity is faster than rgba(). --> <div class="pswp__bg"></div> <!-- Slides wrapper with overflow:hidden. --> <div class="pswp__scroll-wrap"> <!-- Container that holds slides. PhotoSwipe keeps only 3 of them in the DOM to save memory. Don't modify these 3 pswp__item elements, data is added later on. --> <div class="pswp__container"> <div class="pswp__item"></div> <div class="pswp__item"></div> <div class="pswp__item"></div> </div> <!-- Default (PhotoSwipeUI_Default) interface on top of sliding area. Can be changed. --> <div class="pswp__ui pswp__ui--hidden"> <div class="pswp__top-bar"> <!-- Controls are self-explanatory. Order can be changed. --> <div class="pswp__counter"></div> <button class="pswp__button pswp__button--close" title="Close (Esc)"></button> <button class="pswp__button pswp__button--share" style="display:none" title="Share"></button> <button class="pswp__button pswp__button--fs" title="Toggle fullscreen"></button> <button class="pswp__button pswp__button--zoom" title="Zoom in/out"></button> <!-- Preloader demo http://codepen.io/dimsemenov/pen/yyBWoR --> <!-- element will get class pswp__preloader--active when preloader is running --> <div class="pswp__preloader"> <div class="pswp__preloader__icn"> <div class="pswp__preloader__cut"> <div class="pswp__preloader__donut"></div> </div> </div> </div> </div> <div class="pswp__share-modal pswp__share-modal--hidden pswp__single-tap"> <div class="pswp__share-tooltip"></div> </div> <button class="pswp__button pswp__button--arrow--left" title="Previous (arrow left)"> </button> <button class="pswp__button pswp__button--arrow--right" title="Next (arrow right)"> </button> <div class="pswp__caption"> <div class="pswp__caption__center"></div> </div> </div> </div> </div> <link rel="stylesheet" href="/css/companion.css"> <script>window.COMPANION={"enable":true,"name":"小满","tone":"warm","api":"","hint":"点我和我说说话","timeout":9000,"chips":["今天很累","有点焦虑","被打击了","夸夸我","睡不着","就想静静"]};</script> <script defer src="/js/companion.js"></script> <!-- 页面点击小红心 --> <script type="text/javascript" src="../source-src/js/clicklove.js"></script> </div> <script src="/live2dw/lib/L2Dwidget.min.js?094cbace49a39548bed64abff5988b05"></script><script>L2Dwidget.init({"model":{"jsonPath":"/live2dw/assets/shizuku.model.json"},"display":{"position":"right","width":150,"height":300},"mobile":{"show":true},"log":false,"pluginJsPath":"lib/","pluginModelPath":"assets/","pluginRootPath":"live2dw/","tagMode":false});</script></body> </html>