本文作者原创,首发在本博客;CSDN 上的同名文章已标注为转载并回链到本页:https://blog.csdn.net/qq_30220519/article/details/154749672
常用方法
• 消除冗余工作。理念:不要做你不需要的或已经完成的工作。示例:利用更多 RAM 来减少 CPU 和 IO 的使用
量(缓存、记忆化、查找表、压缩),预计算已知编译时值,将循环不变计算移出循环,传引用 C++ 对象以避
免传值引起的过度复制。
• 批量处理。理念:聚合多个类似的操作并一次性执行,从而减少重复操作的开销。示例:发送较大的 TCP 数
据包而不是许多小的数据包,分配大块内存而不是为数百个微小对象分配空间。
• 排序。理念:重新排序算法中的操作序列。示例:更改数据布局以启用顺序内存访问,根据 C++ 多态对象的
类型对数组进行排序以更好地预测虚函数调用,将热门函数分组并将其放置在二进制文件中更近的位置。
• 使用另一种语言重写代码:如果程序是用解释性语言(python、javascript 等)编写的,将其性能关键部分重写
成开销更少的语言,例如 C++、Rust、Go 等。
• 调整编译器选项:检查您是否至少使用了以下三个编译器标志:-O3(启用与机器无关的优化)、-march(启
用针对特定 CPU 架构的优化)、-flto(启用过程间优化)。
改变数据布局
1 | struct S { |
现代 C++ STL 的 std::string 实现将前 15-20 个字符保存在堆栈上分配的缓冲区中,只有更长的字符串才会在堆上分配内存.
1 | struct S { |
1 | struct S1 { |
1 | alignas(16) int16_t a[N]; |
内存分配,解决碎片化
https://github.com/google/tcmalloc
内存池-placement-new
LD_PRELOAD=libhugetlbfs.so HUGETLB_MORECORE=yes
低级优化
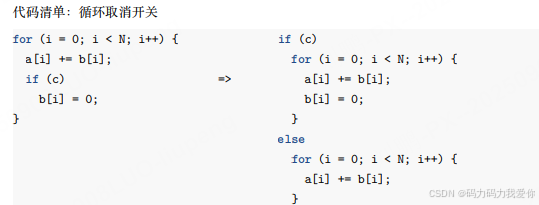
1 | for (int i = 0; i < N; ++i) for (int i = 0; i < N; ++i) { |
1 | for (int i = 0; i < N; ++i) for (int i = 0; i+1 < N; i+=2) { |
按cpu核数拆分循环,增加缓存重用
1 | for (int i = 0; i < N; ++i) int j = 0; |
谓词替换分支
int a;
if (cond) { /* frequently mispredicted */
a = computeX();
} else {
a = computeY();
}如果computeX和computeY为内联函数,可优化为
int x = computeX();
int y = computeY();
int a = cond ? x : y;
冷热代码
https://en.cppreference.com/w/cpp/language/attributes/likely
使用 noinline 属性禁用冷函数的内联,类似 [[unlikely]]
void cold1() __attribute__((noinline))
{ /* 大量的冷代码 (1) */ }
for (;;) {
switch (instruction) {
case NOP: handleNOP(); break;
[[likely]] case ADD: handleADD(); break; // 热代码,高频访问
case RET: handleRET(); break;
// handle other instructions
}
}
工具
https://github.com/parca-dev/parca 随时间的变化持续进行性能分析,采样频率低
https://github.com/facebookarchive/BOLT 二进制程序,块重新排序、函数拆分和重新排序等
创作不易,小小的支持一下吧!